画了几个方块,Transformer 终于有了一点形状
今天学 AI,画了几个方块,突然觉得 Transformer 有了一点形状。
之前我已经接触过 Attention、MLP、参数、训练这些概念。单独拿出来,好像都能解释几句:Attention 让 token 利用上下文的信息,MLP 对它的表示继续做变换,训练则不断调整参数。
但这些概念放在一起,还是有点散。
我知道大模型有几十亿、几千亿个参数,却很难想象:这些参数到底在哪里?它们和 Attention、MLP 又是什么关系?
今天学习 MoE,也就是混合专家模型时,我又被 FFN 卡住了。继续往回追,发现 FFN 就是之前学过的前馈网络,也常被叫作 MLP。绕了一圈,问题又回到了 Transformer 内部。
于是我试着自己画了一张图。
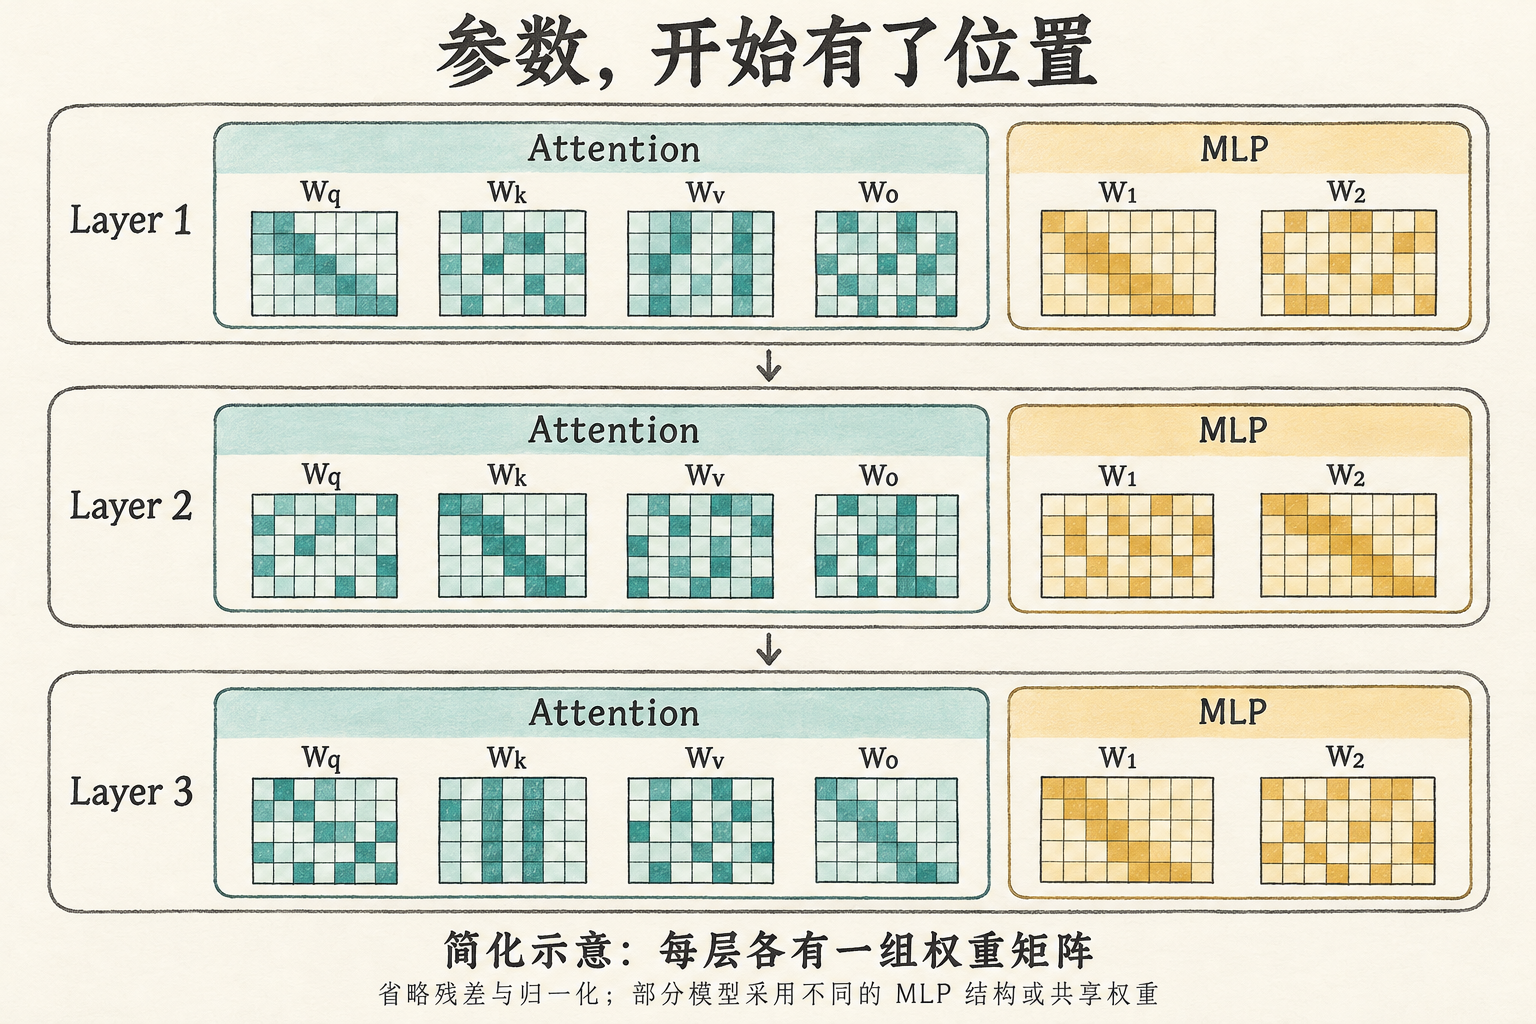
第一层,画几个方块,分别表示 Attention 里的 Wq、Wk、Wv,再画两个方块表示简化的 MLP 权重矩阵 W1、W2。第二层,再画一组。第三层,继续。
画着画着,我突然意识到:这些方块里装的,就是那些参数。
矩阵这个词原本让我想到数学运算。换个角度看,它也是一组按行列组织起来的数,而训练要学习的,正是其中的数值。
在通常不跨层共享权重的 Transformer 中,每一层都有自己的一组矩阵。结构相似,里面的参数却各有各的数值。原来笼统的“几十亿个参数”,开始能被我放回模型的具体位置上。
架构规定有哪些部件、矩阵多大、怎样连接;训练逐步学出其中的数值。输入的表示沿着这些连接,经过一层又一层计算。[1]
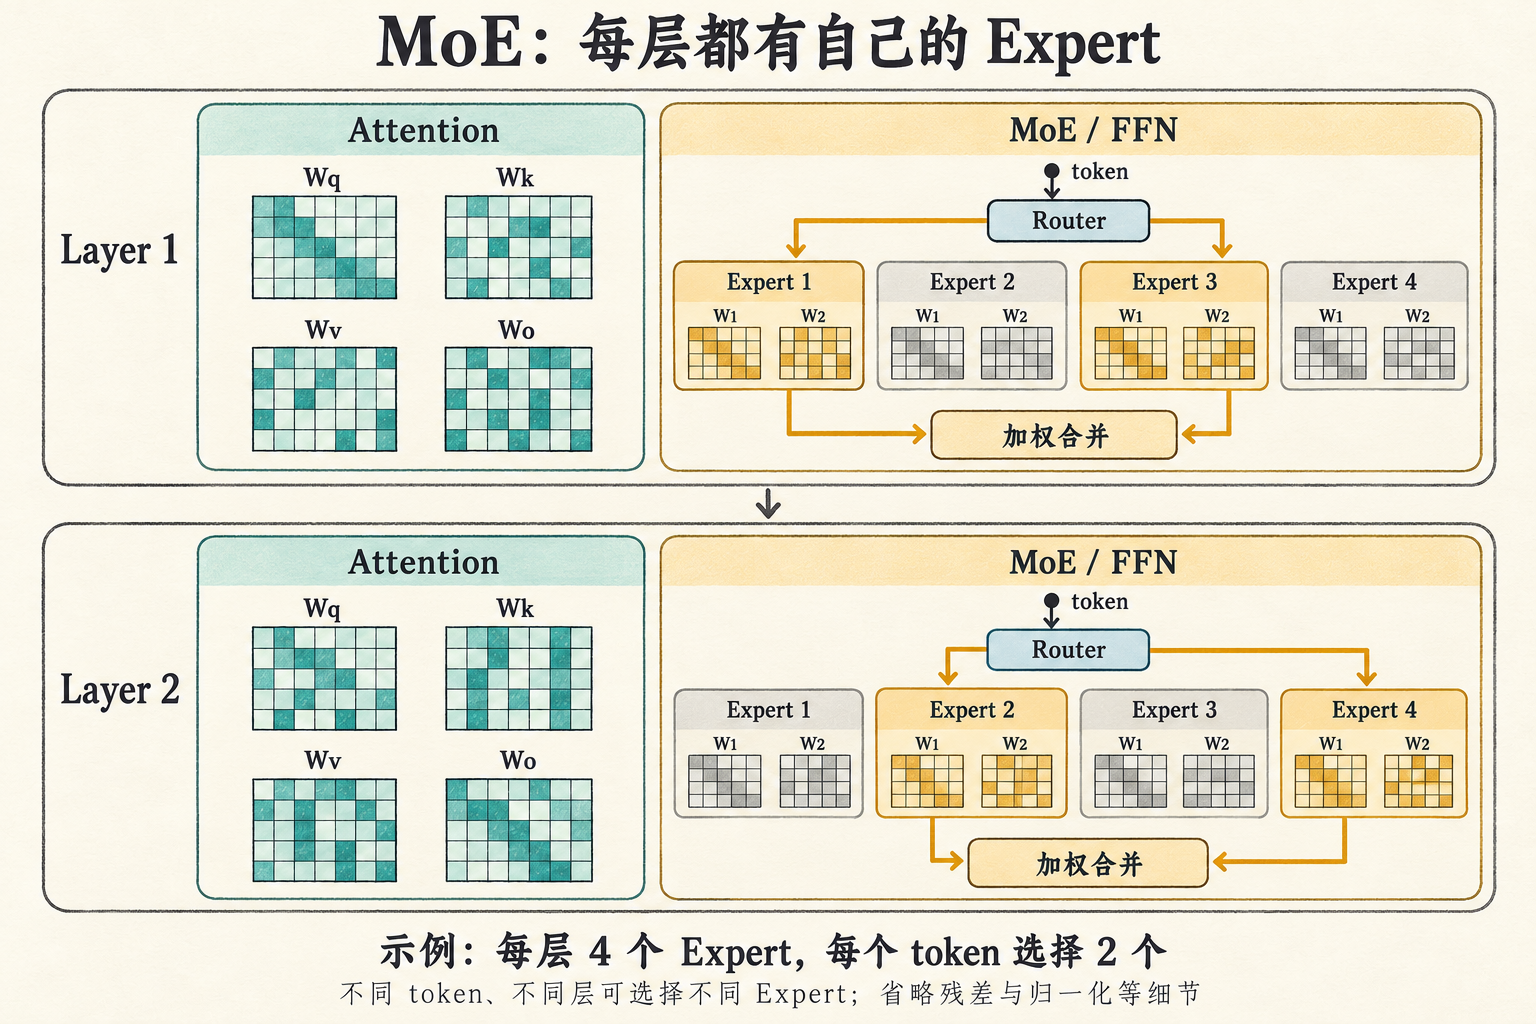
这样再回头看 MoE,也稍微顺了一点:在采用 MoE 的层里,可以把原本的一套前馈网络换成多套专家网络,由路由器根据输入选择其中一部分参与计算。“专家”开始对应到具体的网络和参数上。[2]
当然,我最初那张手绘很粗糙。Attention 还省略了输出投影,真实的前馈网络也可能有更多矩阵,残差连接、归一化等操作都没有画进去。不同模型还会有不同设计。
但它已经足够解决我眼前的一个困难:把几个分别听懂的概念,拼进同一张图里。
我在笔记里写了一句:
Got it, now transformer makes a bit sense to me, I can visualize it by a picture.
现在回头看,这句话挺准确。只是开始有一点感觉,远远谈不上完全理解。
学习抽象知识时,我常常会遇到这种状态:解释听过了,名词也记住了,可脑子里没有一个能摆放它们的地方。直到自己动手画一遍,才发现连接在哪里,也发现之前究竟缺了哪一块。
今天这几个方块,让 Transformer 终于在我脑中有了一个可以继续修改的草图。
2026 年 11 月 2 日的 AI 学习记录。配图为 AI 生成的概念封面与简化示意图。
参考资料:
- Attention Is All You Need:Transformer 架构、Attention 与前馈网络。
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer:可训练的门控网络与稀疏专家组合。