从“知识切片能不能统计”开始,我终于搞懂了 RAG 在干什么
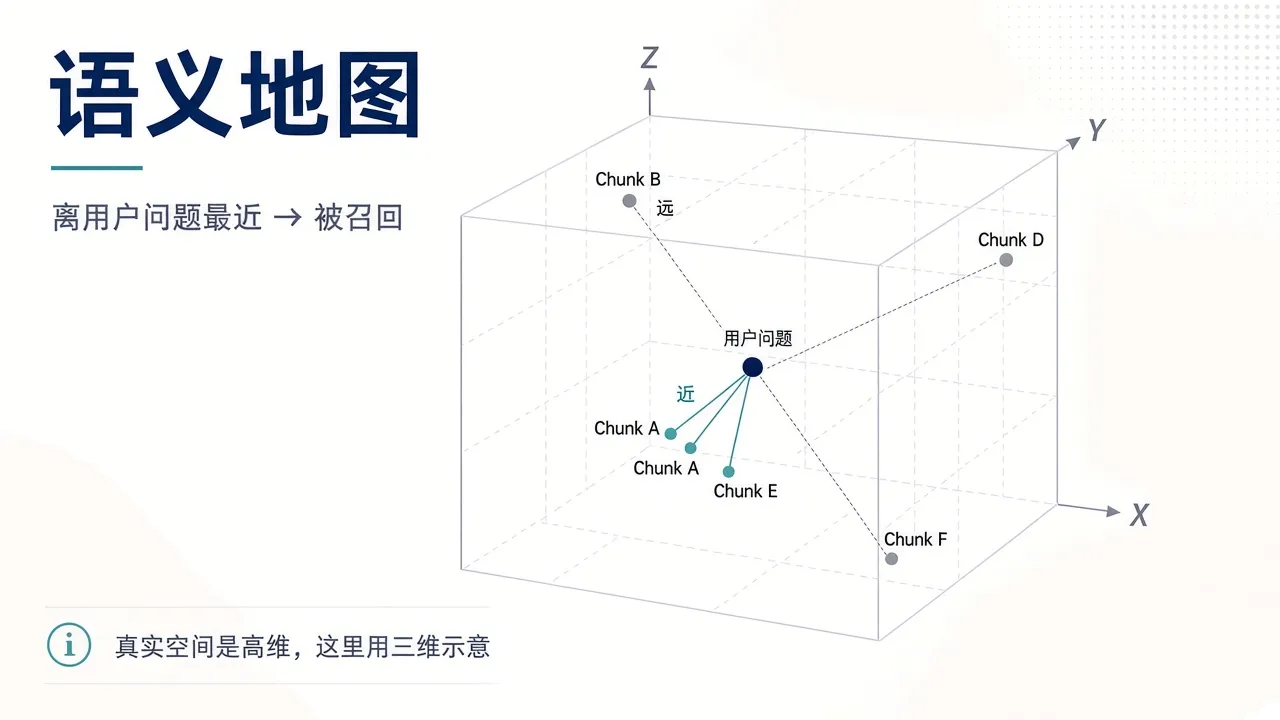
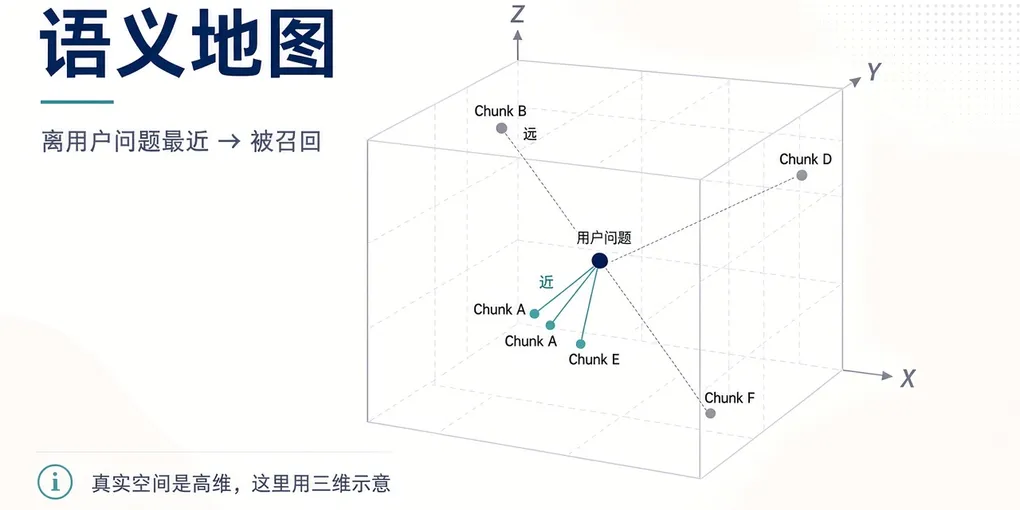
真实空间是高维的,这里用三维示意:离用户问题最近的 Chunk,才会被召回。
最近工作里有个问题,把我卡了好几天。
两边厂商都在谈知识库、知识切片、RAG。有人问:知识切片能不能统计?也就是说,文档切完之后,能不能给出一个“知识点数量”。
一家说可以。另一家说不好这么统计,或者至少不该直接拿切片数当知识点。
我当时真正卡住的,其实不是统计本身,而是没有彻底搞清楚:切片、知识点、RAG、向量检索到底是什么关系。听到“语义分段”“内部优化算法”时,也容易觉得有点蒙——不是问题太刁钻,是当时还没有一套能把这些表述拆开来看的框架。
把 RAG 搞清楚之后,那个“能不能统计”的问题,答案反而变得很清楚。
一、RAG 到底在干什么
RAG(Retrieval-Augmented Generation,检索增强生成)可以先理解为一套“先检索,再生成”的知识问答机制。
一句话版:先找资料,再让大模型根据资料回答。
经典向量 RAG 的基本思路是:把用户问题和知识库内容表示到同一个语义向量空间中,通过向量相似度找到最相关的知识切片,再取回这些切片对应的原始文本,交给 LLM 生成答案。
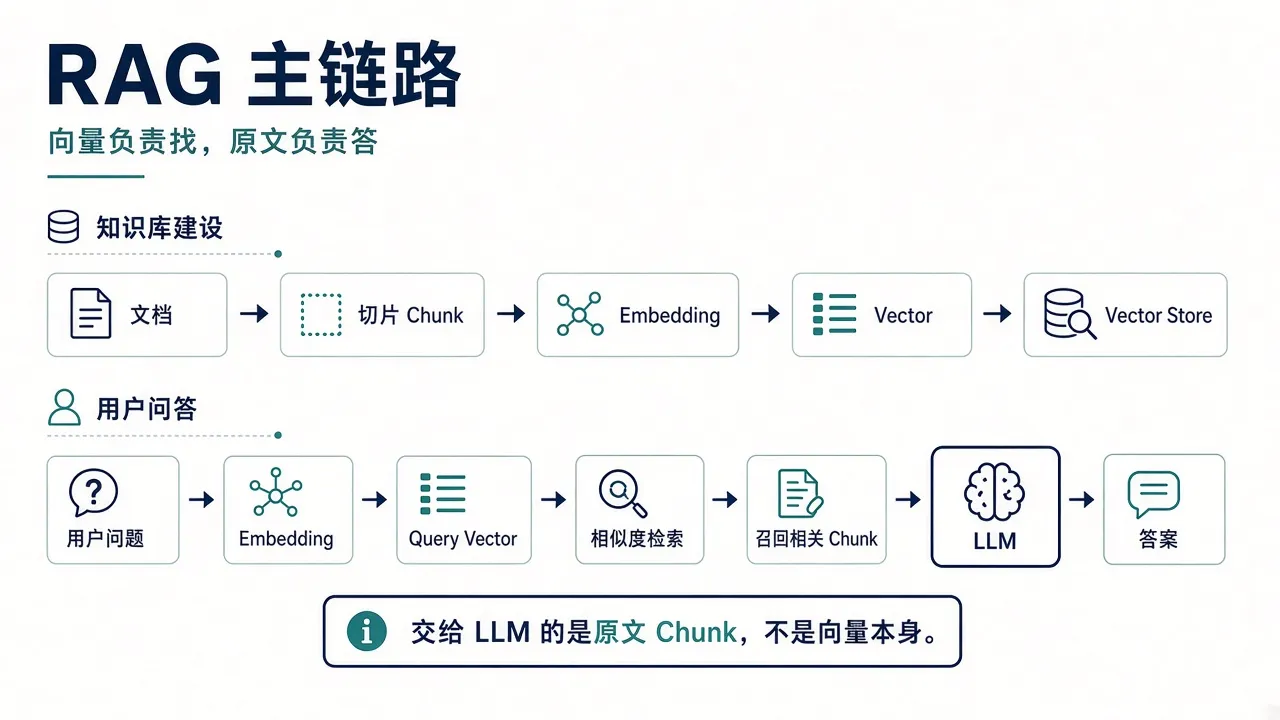
知识库建设一条线,用户问答一条线;向量负责找,原文负责答。
主链路可以拆成两条:
知识库建设阶段:
文档 → 切片(Chunk)→ Embedding → Vector → Vector Store
用户问答阶段:
问题 → Embedding → Query Vector → 与知识库向量做相似度检索 → 召回相关 Chunk → 把对应原文交给 LLM → 生成答案
几个基础词:
- Chunk:文档切出来的文本块,是检索单元。
- Embedding:把文本编码为数字语义表示的过程。
- Vector:Embedding 的输出结果。
- Vector Store:保存向量、对应原文 Chunk,以及文档来源、标题、页码等元数据的可检索结构。
- 召回:从知识库中把可能与问题相关的候选知识片段找回来。
需要注意:真正交给 LLM 的通常不是向量本身,而是向量所对应的原始文本 Chunk。向量主要用于“找”,Chunk 才是被用于回答的知识内容。
因此可以把经典向量 RAG 再压缩成一句:
知识库先把文本变成可比较的语义向量;用户问题也变成向量;两边做相似度检索,找到最相关的原文切片,再由 LLM 根据这些材料组织答案。
二、最难理解的部分:语义切片和向量
原始文档通常不能整篇直接用于检索,需要先拆分成若干 Chunk。
切片方式常见有三类:
- 规则切片:按标题、段落、句号、换行、条款等结构切分。
- 固定长度切片:按字符数或 Token 数控制每个 Chunk 的大小,必要时加入 Overlap。
- 语义切片:根据前后文本语义是否连续、主题是否发生变化来判断切分边界。
实际产品中通常不是三选一,而是混合使用,例如“先按标题/条款粗切,再做语义判断,最后用长度规则修正”。
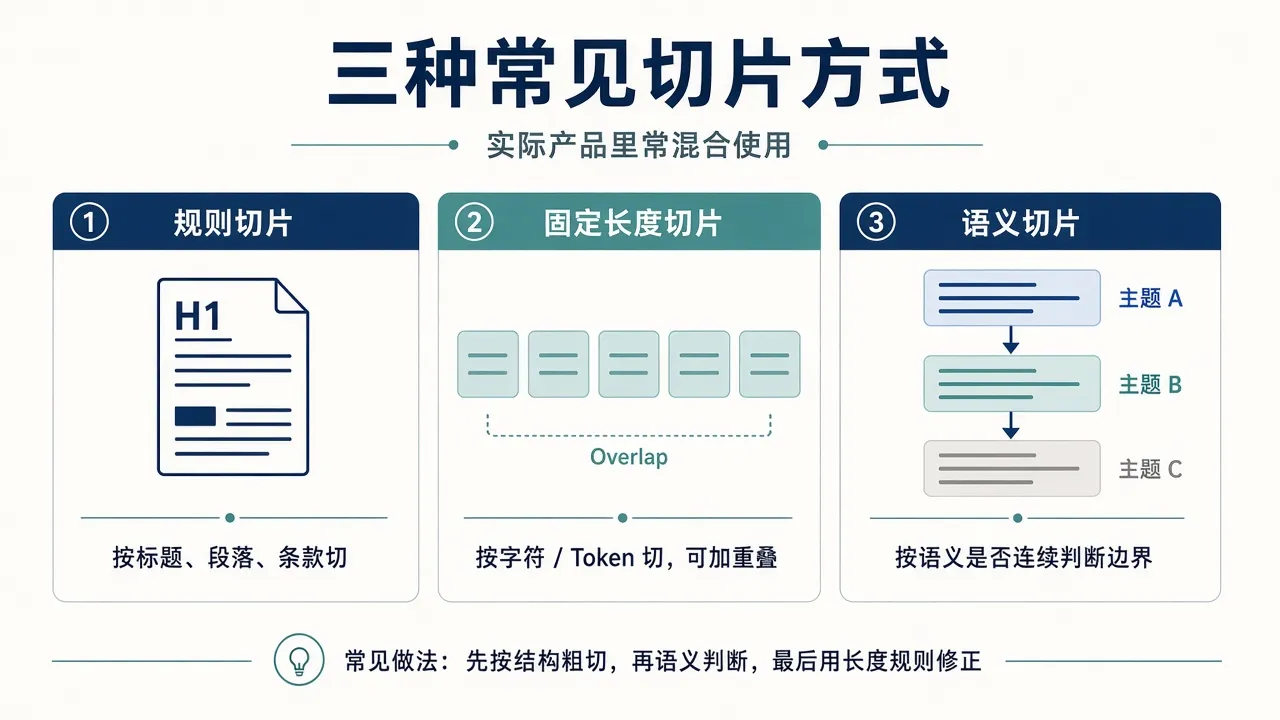
规则、固定长度、语义三类;产品里常见做法是组合使用。
语义切片的核心不是“每 500 Token 切一次”,而是尽量让每个 Chunk 保持一个相对完整的语义单元。
一种常见实现思路是:
文本先被拆成句子或较小段落 → 用语义模型做 Embedding → 得到各段 Vector → 比较相邻 Vector 的语义距离 → 发现主题明显变化的位置 → 形成切分边界。
Embedding 是“把文本编码为数字语义表示”的过程;Vector 是 Embedding 的输出结果。可以把它粗略理解为:Embedding 模型把一句话放到一张高维“语义地图”中,而 Vector 就是这句话在这张地图上的坐标。实际向量通常有几百到几千维。每个维度不需要人工解释,它们共同表达文本的语义位置。
现代语义模型通常与 Transformer / Attention 技术体系同源。模型在预训练阶段已经学习了大量语言和语义关系,语义切片是在应用阶段利用这种已学到的语义表示能力,而不是现场重新训练模型。
因此更准确地说:
Transformer / Attention → 形成语义理解能力 → Embedding → Vector → 相似度/变化点判断 → Split。
这也是为什么听到“基于语义分段规则并结合内部优化算法进行知识切片”时,不能直接理解为“由厂家 LLM 负责切片”。实际底层可能是规则型 Splitter、Embedding / 语义相似度型 Splitter、LLM 型 Splitter,或以上多种方式组合。后面更有用的问法是:
你们的语义切分底层主要使用规则、Embedding 相似度,还是 LLM 判断?三者分别在哪一步参与?
三、回到最开始的问题:知识切片不等于知识点
搞清前面这条链路后,“知识切片能不能统计”就没那么玄了。
Chunk 是 RAG 技术链路中的检索单元;“知识点”则是业务或统计概念。两者不能默认等同。
同一份文档采用不同切片策略,可能得到完全不同的 Chunk 数量。例如,同样一段内容:
- 粗粒度切分可能得到 1 个 Chunk;
- 细粒度切分可能得到 3 个 Chunk;
- 带重叠的切分可能得到 2 个或更多 Chunk。
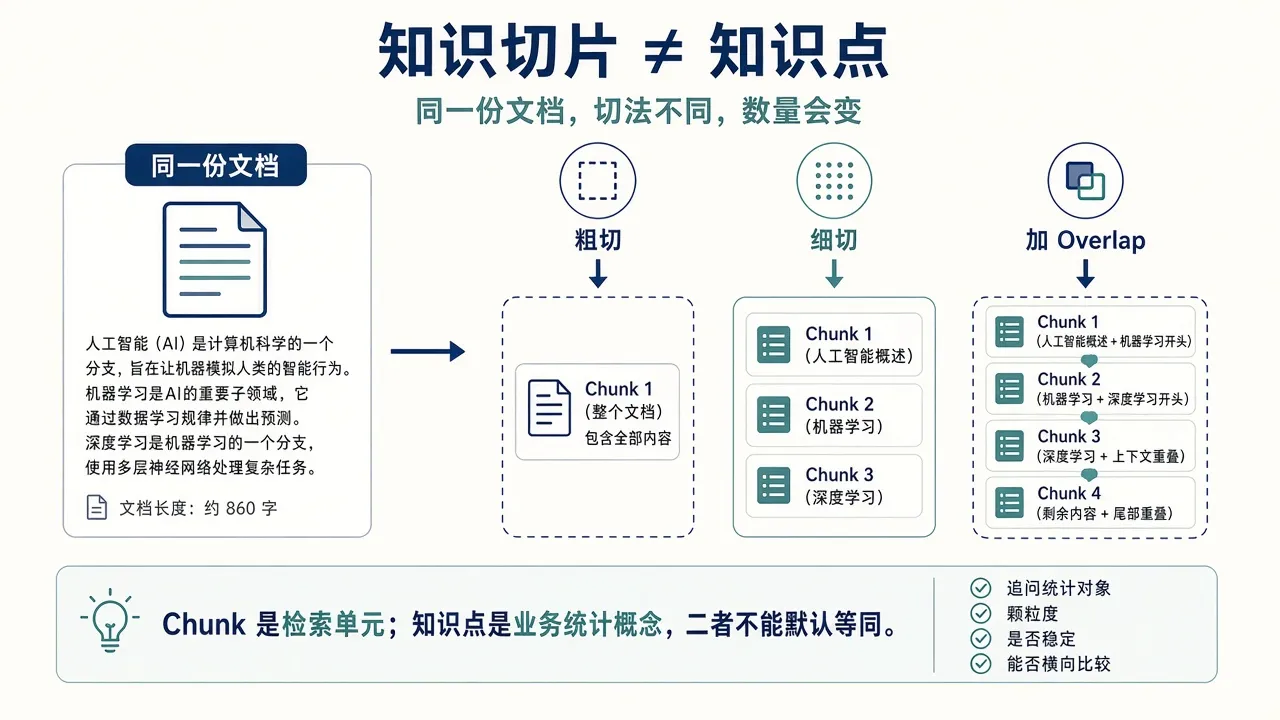
同一份文档,切法不同,数量会变;所以不能天然把 Chunk 数当成知识点数量。
因此,“知识点数量”只有在知识点定义、颗粒度和生成规则统一后才具有可比性。
如果厂家声称“可以统计知识点”,需要继续确认:
- 统计的是最终 Chunk 数量,还是进一步抽取后的独立知识单元?
- 知识点的定义和颗粒度是什么?一个知识点是否有独立标题、正文、来源和原文定位?
- 同一份文档重复处理后,知识点数量是否稳定?
- 不同厂家之间是否采用统一规则,数字能否横向比较?
如果这些问题答不清楚,那个“知识点数量”更像产品展示数字,而不是可对比的业务指标。
技术学习的价值,不是记住术语,而是以后再听到“语义分段、向量检索、内部算法”时,知道下一步该问什么。
结尾
这次真正搞清楚的,不只是 RAG 的一条技术链路,而是开始知道怎样把厂商的技术表述拆开来看:谁在切、怎么切、向量怎么来、怎么召回、所谓“知识点”到底是什么。
技术不再只是黑盒,至少已经能继续往下问了。