我给自己的资料库接上了 ChatGPT
我记东西已经有一段时间了。
每天随手想到的事,放在 Memos;需要展开写的,放在 Google Docs;有些东西想得差不多了,再整理成博客。最近又做了 Idea Keeper,想把散落在不同地方、其实在讲同一件事的记录重新串起来。
记录多了以后,经常碰到一个问题:明明记得自己想过,也写过,但就是找不到。
有时候和 ChatGPT 聊到一个想法,我会突然觉得,这个问题半年前好像就讨论过。当时为什么这么想?后来有没有变化?如果能把那几条记录拿出来,也许就不用每次从头说一遍。
以前只能自己找。先猜放在哪,再猜用了什么词,翻一圈,有时找到了,有时顺手看了半天别的,最初想找什么反而忘了。
今天折腾 Personal RAG,就是想先解决这件事。
先让它能找到我的记录
我没有打算重新搬一次资料。Memos、Google Docs 和博客都已经在用了,再弄一个地方存东西,后面还得想办法保持一致。
Personal RAG 做的,是把这几个来源放进同一个搜索索引。原文还留在原来的地方,以后有问题,可以从一个入口找。
搜索用了两种办法。语义搜索负责找意思相近的内容,关键词搜索负责那些需要准确对上的东西,比如人名、日期,或者我记得很清楚的某个词。两边的结果再合起来,也就是 Hybrid Search。
之前学 RAG、embedding 的时候,这些原理已经懂了一些,这次讨论怎么做,就更能跟上,也知道该追问哪里。真正拿自己的资料做一遍,又更清楚了它们分别有什么用。有时候我根本想不起当初用了哪个词,只记得大概在想什么;有时候恰好相反,我就记得一个名字,需要把它找出来。
接下来是 MCP。放在这件事里理解,就是让 ChatGPT 能调用我这套系统。
目前接了三个工具:hybrid_search 找资料,get_source 继续取原文,create_memo 在我明确要求时,把整理好的内容写回 Memos。
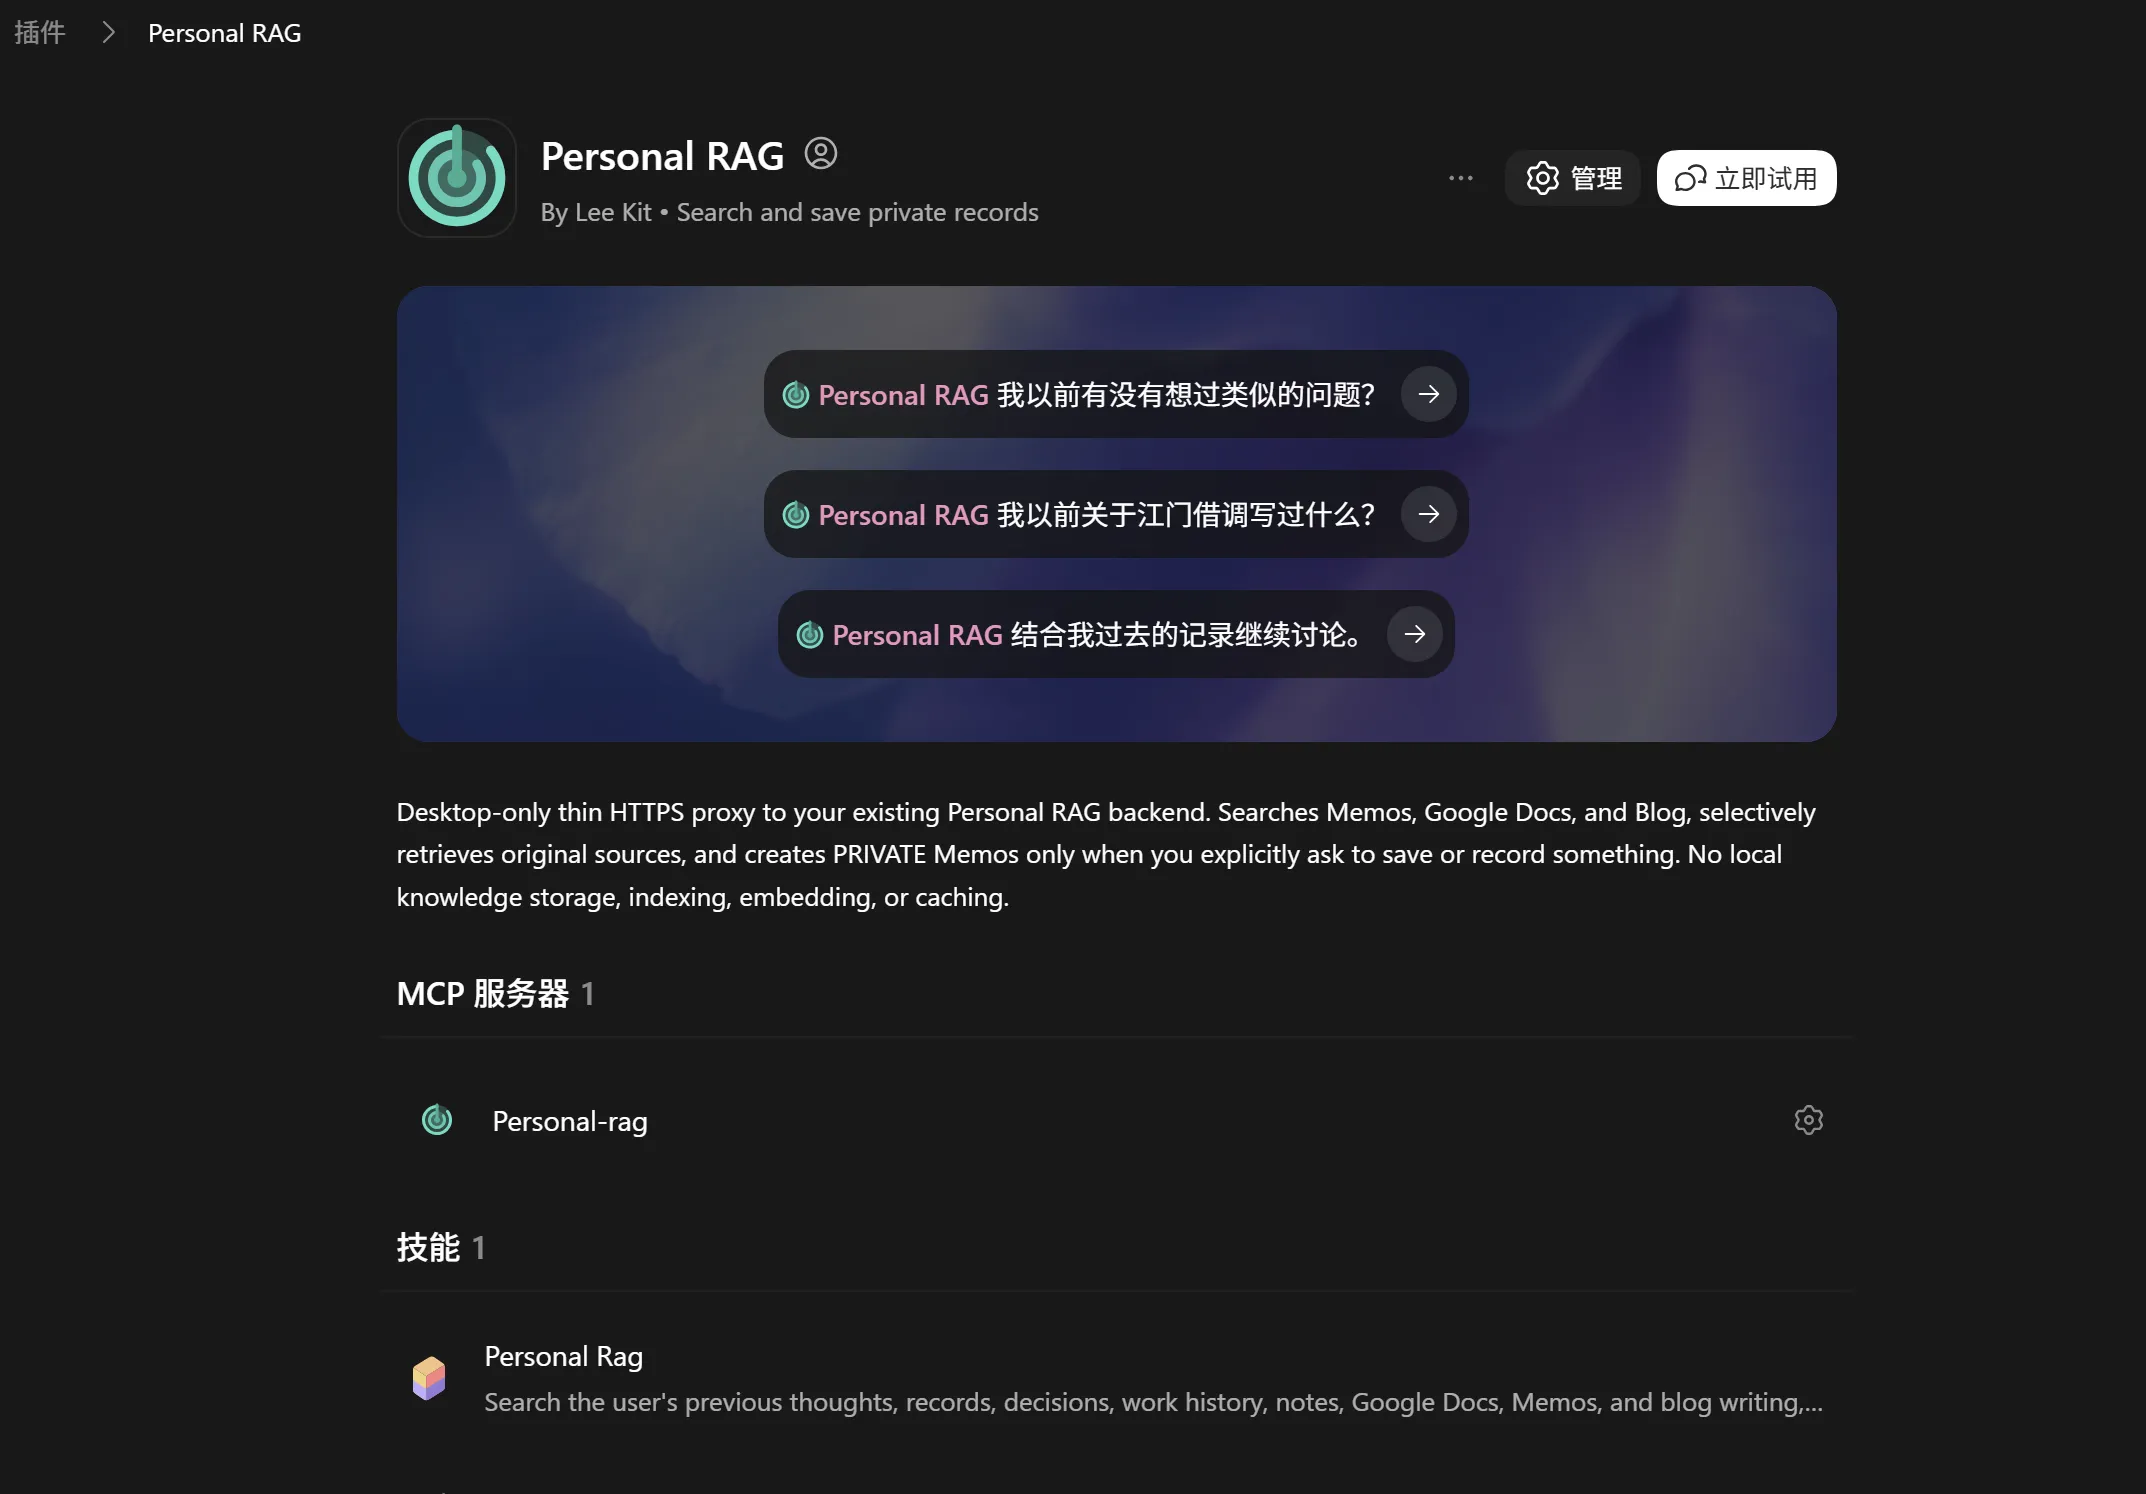
Personal RAG 插件:从已有的 Memos、Google Docs 和博客里搜索记录。
第一次认真试,我问了一个很私人的问题:
“找找我为什么想离开现在的工作。”
它开始从过去的记录里找。有几个月前的 Memo,有后来写得比较完整的文档,也有已经整理成博客的内容。
这个问题当然可以直接和 ChatGPT 聊,我也聊过很多次。但这次看着不同时间的原文被找出来,感觉还是不太一样。有些事我还记得,有些当时写得挺认真,现在已经很久没想起了。
把它们放在一起,才能接着看:哪些想法一直都在,哪些是最近才出现的,哪些当时觉得很重要,后来慢慢变了。
之前留下的记录,终于可以直接拿来继续讨论了。
能写进去,和用起来顺手,还是两回事
搜索通了以后,很自然又想到:既然能把过去的东西找回来,那聊完产生的新东西,能不能顺手存进去?
于是加了 create_memo,可以通过 MCP 创建一条私密 Memo。
第一次测试,我让它写了一句:
“Personal RAG 写入功能今天正式跑通了。”
然后打开 Memos,确实在那里。
这种测试看起来有点傻,专门写一句话,再去另一个页面确认。不过自己搭东西的时候,看到它真的出现,还是挺高兴的。前面讨论过的接口、权限和调用,到这里终于变成了一条能看见的记录。
想要的使用方式:聊完以后,把值得留下的内容存进 Memos。
但高兴完,很快又发现不太对。
在我当天使用的环境里,这套 MCP 跑在桌面端的本地 Work 模式中,普通 Chat 还不能直接调用。我如果在平常的聊天里聊出一点东西,还是得复制下来,切到 Work,再让它写进 Memos。
那我为什么不直接贴进 Memos?
绕了一圈,操作反而多了。
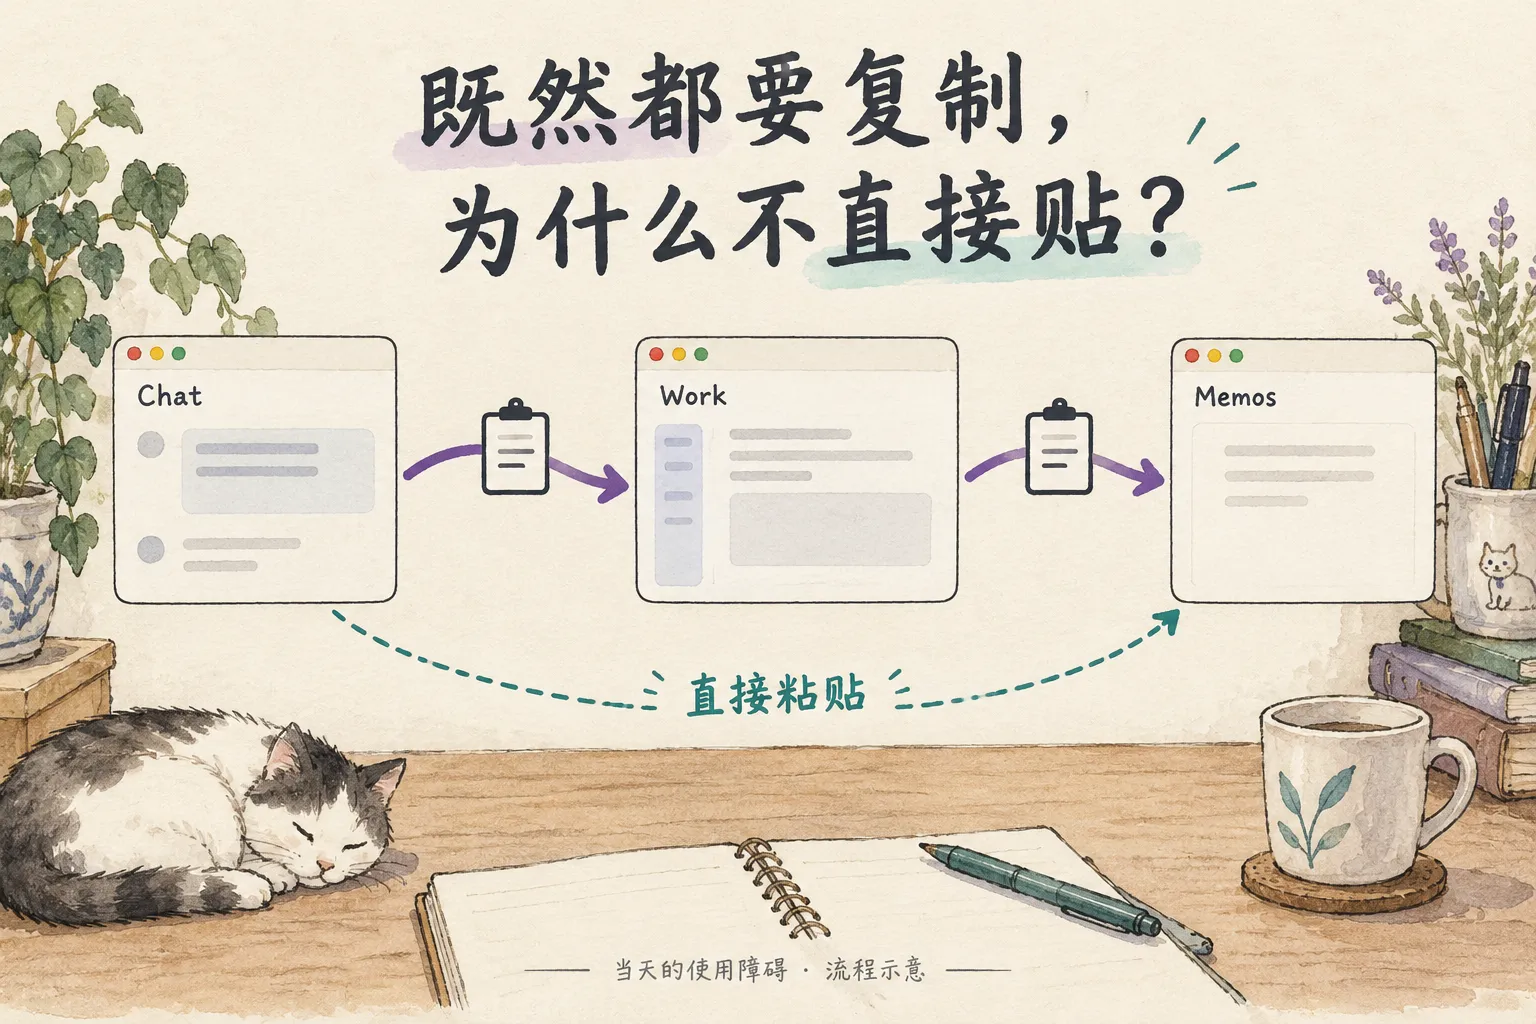
功能接上了,操作还没变顺手。
所以这一天只能说写入功能跑通了。至于“聊完以后顺手记下来”,还没有真正做到。接口有了,但我平时使用的地方还没接上。
我希望以后能在原来的对话里说一句“这个记一下”,它就把内容整理好、存进去。现在还差这一段。
实际使用时,也碰到过插件说明能读到,检索工具却没有出现在当前会话里的情况。有一次,它明确说没有实际搜到原始记录,只能根据已有的讨论回答。同样一个问题,有没有真正调用搜索,还是得分清楚。
“这次没有实际搜到你的原始记录。”
做伴书鼠的时候,又接上了一件事
下午继续做伴书鼠,这个出口突然有了更具体的用处。
我平时看 PDF,还是习惯直接划线、写批注。读到哪里,就在那里记。伴书鼠也是沿着这个习惯做的,先让我把书看下去。
但看完以后,这些批注怎么办?
它们如果一直留在 PDF 里,以后想找一句话,还是得先想起是哪本书,再打开文件翻。读的时候记下来了,过一阵又找不到,和前面的问题其实一样。
于是我们决定,让伴书鼠把阅读记录整理成普通 Memo,带上书名、页码、我的批注和原文上下文,再交给 Personal RAG 去索引。
这样以后讨论一个问题时,就有机会把这些阅读记录一起找出来。伴书鼠也不用再单独做一套 embedding 和向量数据库。已经有一套负责找资料的东西,就先接着用。
不过接到这里,又发现少了一步:Memo 写进去了,不代表搜索马上就能找到。
之前的索引不会随着每次写入立刻更新。对普通记录来说,也许晚一点没什么;但如果我刚读完一段,存好批注,转头就想和 ChatGPT 讨论,结果它说找不到,就很别扭。
所以又补了即时索引。新 Memo 创建以后,接着切分内容、生成 embedding、写进索引,完成后就可以搜索。
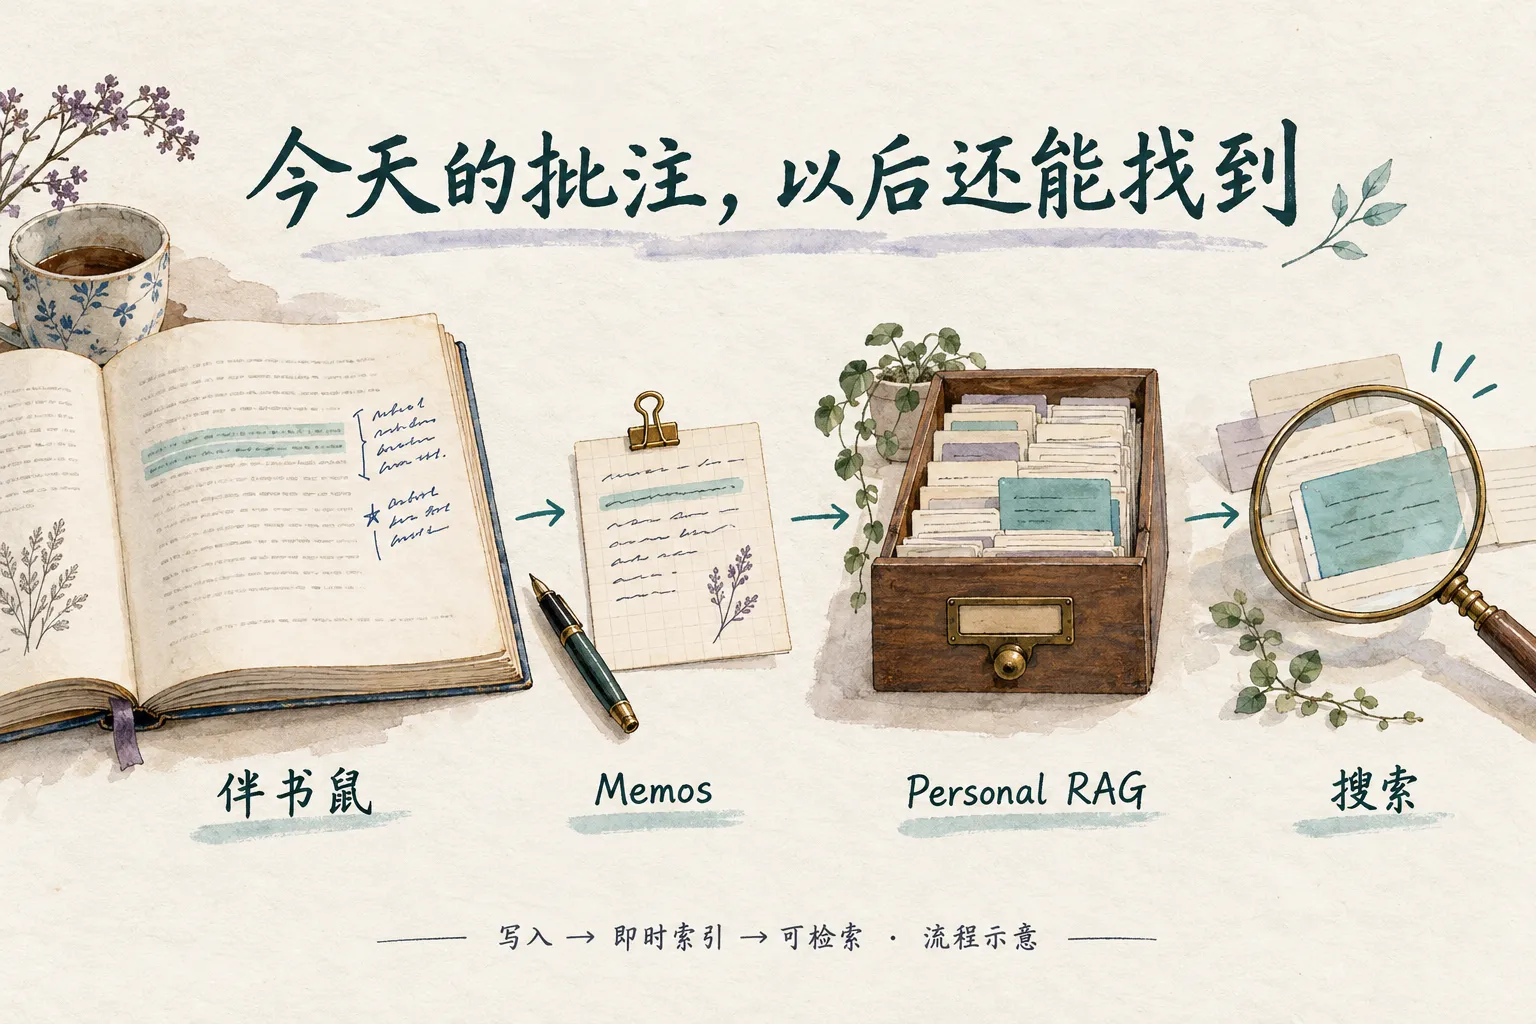
伴书鼠负责留下阅读记录,Personal RAG 负责以后找回来。
最后专门走了一次完整测试:创建一条 Memo,确认 Memos 里有,再看数据库里的 document 和 chunk,最后用一个只有这条记录才有的随机关键词去搜。
搜到了,再把测试数据清掉。
终端最后留下两行:
PASS: END-TO-END COMPLETE
Memo create -> immediate index -> hybrid search -> cleanup
看到这两行,才算把这件事放下。单独测每个接口都成功,和一条记录真的从写入走到能搜出来,心里还是有差别。
然后,真实内容一放进去,又报错了
本来以为差不多了。结果伴书鼠第一次拿真正的阅读记录来写 Memo,又出了问题:
RequestEntityTooLarge
正文只有 9144 bytes,连 10KB 都不到,怎么就太大了?
查了一圈,最后找到的是之前给 Idea Keeper 留下的设置。Flask 接口有一个全局请求限制,只有 16KB。正文自己的大小,和包成 JSON 以后整个请求体的大小,还不是一回事;中文经过转义,请求也可能进一步变大。
最后把单条 Memo 正文上限调到 128KB,整个 HTTP 请求上限调到 256KB。伴书鼠原来保留的三页上下文,也就不用为了这个限制砍掉。
这个问题让我觉得挺有意思。
前面拿一句“写入功能跑通了”测试,当然什么都好。真拿阅读内容来用,带上批注和几页上下文,一个以前随手设的小限制,就把整件事卡住了。
如果只画流程图,Memo 写入、索引、搜索,几根箭头已经连好了。可真正用的时候,一条不到 10KB 的正文照样进不去。
最近和 AI 一起做东西,越来越多是这种过程。先有一个想解决的问题,做出一点,拿来用;用着发现这里不顺,那里又报错,再回去改。很多后面要做什么,都是这样才知道的。
以后再想到一个问题,可以接着往下聊
晚上回头看,这一天做的事情其实挺零碎。
接搜索,接 MCP,加写入,补即时索引,最后又改了一个请求大小限制。中间还认真怀疑过,既然要复制到另一个窗口,这个功能做出来到底有什么用。
不过把这些事情放在一起,已经能看出一点变化。
以前看书、和 ChatGPT 聊、写 Memo、整理博客,都是我在做的事。它们也有联系,只是很多联系需要我自己记着:这个问题以前在哪聊过,这个想法是哪本书里来的,那篇博客之前有没有留过更早的记录。
时间一长,就记不住了。再碰到同一个问题,往往只能凭当下的印象重新讲。
现在至少可以先去找。找到以前的原文,看看当时的处境和想法,再接着讨论。伴书鼠的批注也有了一个出口,读完以后,可以和其他记录放在一起被找到。
当然,还没有全部接好。普通聊天里的写入体验仍然差一截,后面接 Remote MCP,也还要看实际用起来怎么样。
但今天搜出那些旧记录的时候,我已经觉得,之前随手写下来的东西开始有用了。
有些话写的时候,并不知道以后还会拿来做什么。可能只是那天有点烦,想记两句;也可能是读到某一页,突然想到一件自己的事。
过了几个月,我又碰到了类似的问题。现在有办法把当时的话找出来,看看自己已经想到了哪里。
先继续用吧。下一次读书、聊天,或者又冒出一个以前想过的问题,再看看还有哪里接不上。