学了一天 AI,才发现自己没弄懂“神经元”
今天几乎用了一整天学习 AI。
Neuron、feature、superposition、Sparse Autoencoder……几个词来来回回,看图、讨论,再回头看 Transformer。一度觉得明白了,接着问两句,又发现前面还有个洞。
最让我卡住的,是一个早就听过、以为自己已经懂了的词:神经元。
一个神经元,就是一个参数吗?
我在学习记录里问:
one neuron is one parameter in LLM, 1/671B, right?
一个神经元,就是大模型几千亿参数里的一个,对吧?
结果不对。
参数是模型里学出来的数值,例如权重矩阵中的一个数。神经元则是一个计算单元:接收很多输入,分别乘上权重,加起来,再经过激活函数,产生一个输出。
这么说其实也不复杂。可问题是,之前听到参数、神经元、向量、特征,我脑海里虽然都有点印象,它们之间的关系却一直没接上。
所以,当讨论已经走到 superposition 的时候,我反而要求退回去:先别往下讲了,回到 Transformer,看看 MLP 到底怎么算。我连 neuron 是什么都还没弄明白。
12,288 → 49,152 → 12,288
这次用 GPT-3 的 175B 版本做例子。它有 96 层 Transformer,隐藏维度是 12,288。先暂时放下 Attention、残差连接等部分,只看其中一层的 MLP,事情终于具体了一点。模型配置见 GPT-3 论文。
进入 MLP 的,是代表某个 token 当前状态的 12,288 个数。
经过第一组权重计算,变成 49,152 个数;经过 GELU 激活函数,仍然是 49,152 个数;再经过第二组权重计算,回到 12,288 个数。
12,288 → 49,152 → GELU → 12,288。
这里只画了 MLP 的简化计算,不是完整 Transformer 层。
这时我才开始看见,所谓中间的 49,152 个神经元,是什么意思。
每个神经元都要对输入的那一串数字做一次加权计算。仅第一组矩阵中,与一个中间神经元对应的,就有 12,288 个输入权重。它怎么会只等于一个参数呢?
之前脑海里模糊的“很多点和很多线”,终于能和矩阵里的数字对上了。后面还有很多层,各层又有各自的权重,并不是把同一组矩阵重复用 96 次。
中间那个 GELU,我也追问了一阵。为什么一定要非线性?随便找个平方、三次方、四次方拼起来的公式,行不行?
先记住的一点是,如果中间没有非线性,连续两次线性变换仍然可以合成一次线性变换。层数看着增加了,却没有因此获得我们期待的那种表达能力。至于为什么选这种函数、什么函数容易训练,还得考虑数值和梯度的表现。我今天只先理解到这里。GELU 原论文讨论了这种激活函数的设计。
那么,“猫”在哪里?
神经元稍微清楚了,feature 又让我困惑。
前面说 feature 可以用一个向量方向来理解,我马上问:vector 就是 feature 吗?为什么又换了一个名字?
而且,cat 这个 token 经过 embedding,不也已经变成向量了吗?它和后面说的“猫相关特征”,到底是什么关系?
我当时试着把 feature 理解成“含义”:我们读到一个词,会想到它的含义;模型内部,也会有与这个词相关的表示。
这个联想帮我往前走了一点,但“含义”仍然太笼统。一个 token 的 embedding,不等于一个完整的概念;feature 也未必对应一个我们能直接叫出名字的东西。向量是数学上的表示,特征则是在讨论模型学到了什么模式。不能看到一串数字,就说它是一个特征。
我原来想找的,隐约还是一个明确的位置:猫放在这里,兔子放在那里。
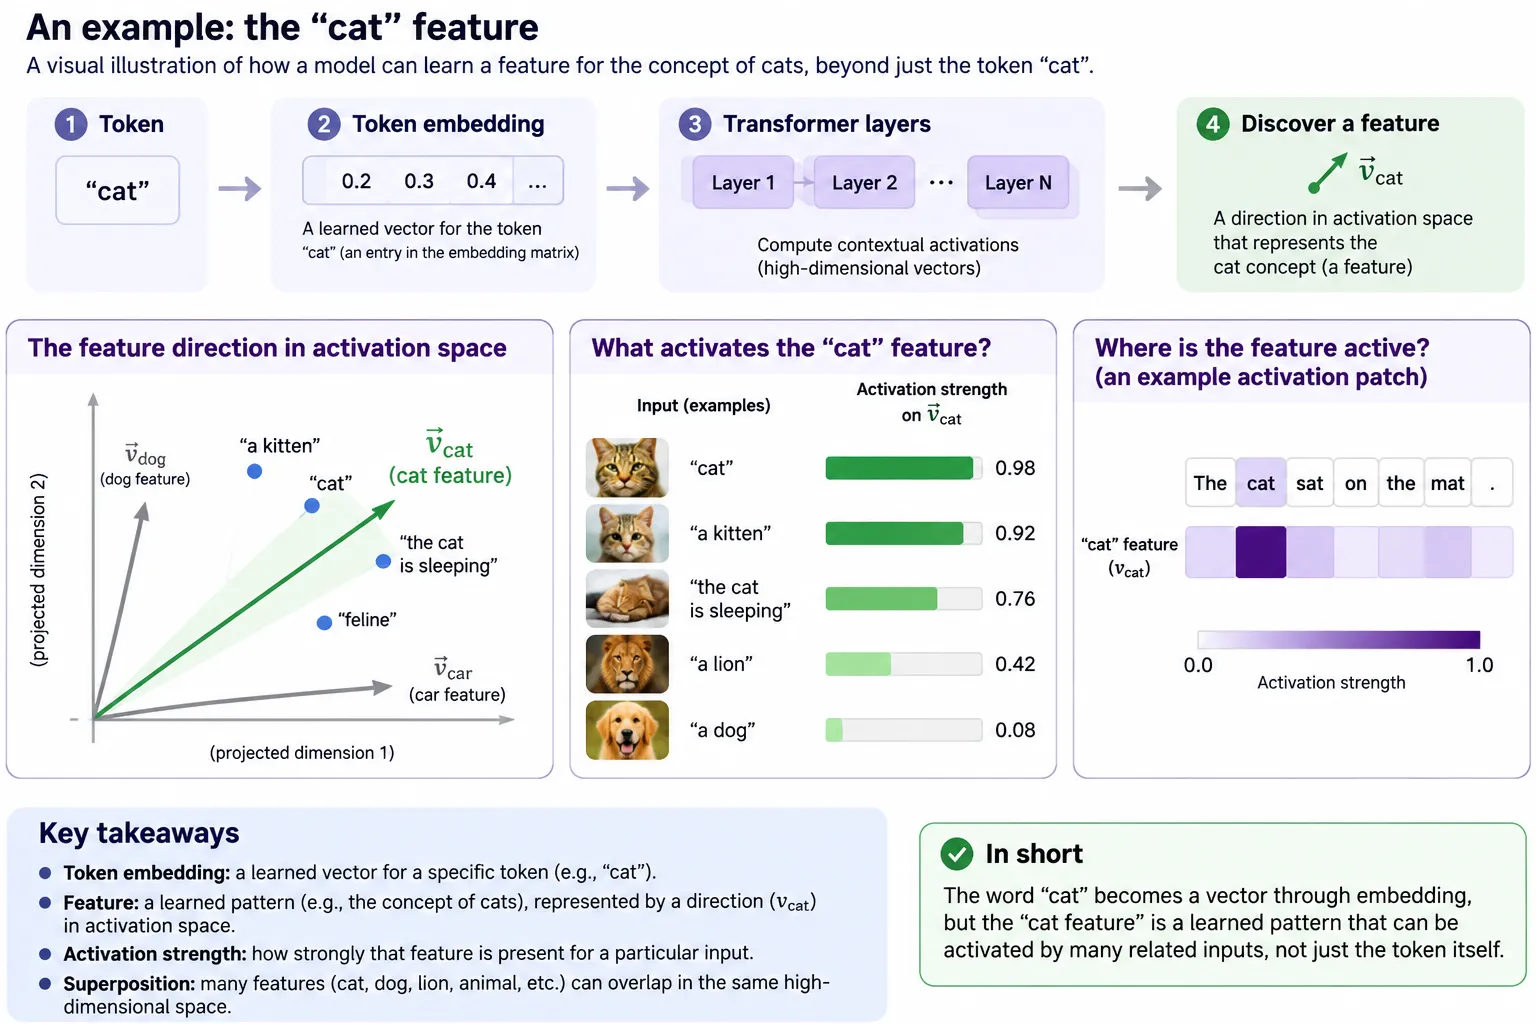
今天学习时保存在在线文档中的示意图。图中的数值、方向和激活热图用于帮助理解,不是真实模型的测量结果;“猫相关特征”也不意味着模型只有一个完整代表猫的方向。
可模型内部的表示,偏偏不一定按这个办法组织。
我的“参数海胆”,需要重新想一想
以前我给自己想象过一只“参数海胆”,用来理解大模型里复杂的知识和连接。
今天看到特征方向的图,我又把它想起来了:如果把一个个方向想成海胆的突起,是不是就容易理解一些?
我在记录里写:
I’ve managed to visualize it by 突起=vector.
这个形象终于有了一个更具体的落脚点。不过名字虽然还叫“参数海胆”,现在想象的突起,更接近激活空间中的特征方向,而不是每根刺对应一个权重参数。
参数在训练中逐渐调整,让这样的内部表示能够形成;处理某次输入时,变化的是具体的激活状态。不同层、不同位置,也有各自的表示空间,不能把整个模型真画成一只固定的海胆。
比喻能帮我理解,也会偷偷带进错误。今天它有用的地方,是让我开始想象:一个特征方向,可以涉及多个神经元;一个神经元的活动,也可能参与不同特征的表示。
于是,神经元的数量,就不能直接当成模型懂得多少概念的数量。
Superposition,不就是向量求和吗?
看到几个特征组合在一起,我的第一反应很直接:
看起来就像是 向量和?向量求和
往下才分清,向量求和本身,不足以说明 superposition。
这里讨论的 superposition,通常译作“叠加”,关注的是模型如何利用有限维度,表示比维度数更多的特征。不同特征共享一些维度,方向不必彼此正交,因此也会带来干扰。特征比较稀疏、不是同时大量活跃时,这种表示方式就可能有利。这是我从 Toy Models of Superposition里开始接触到的思路。
学习时用了一个极简例子:在二维空间里,三个方向分别是(1,0)、(0,1)和(1,1)。
如果看到结果(1,1),它可能来自第三个方向,也可能是前两个方向相加。
算出向量和很容易,反过来判断里面有哪些成分,就没那么简单。这个例子当然不能直接代替真实模型,但至少让我看到了“混在一起”带来的问题。
我还问,为什么需要 superposition,是为了把一句话解码出来吗?
这个问题也暴露了我的习惯:听到一个新概念,就想把它塞进流程图,找出它属于哪一步。
但 superposition 描述的是一种可能在训练中形成的表示方式。它不是 Transformer 流程里额外加上的一道“叠加工序”。
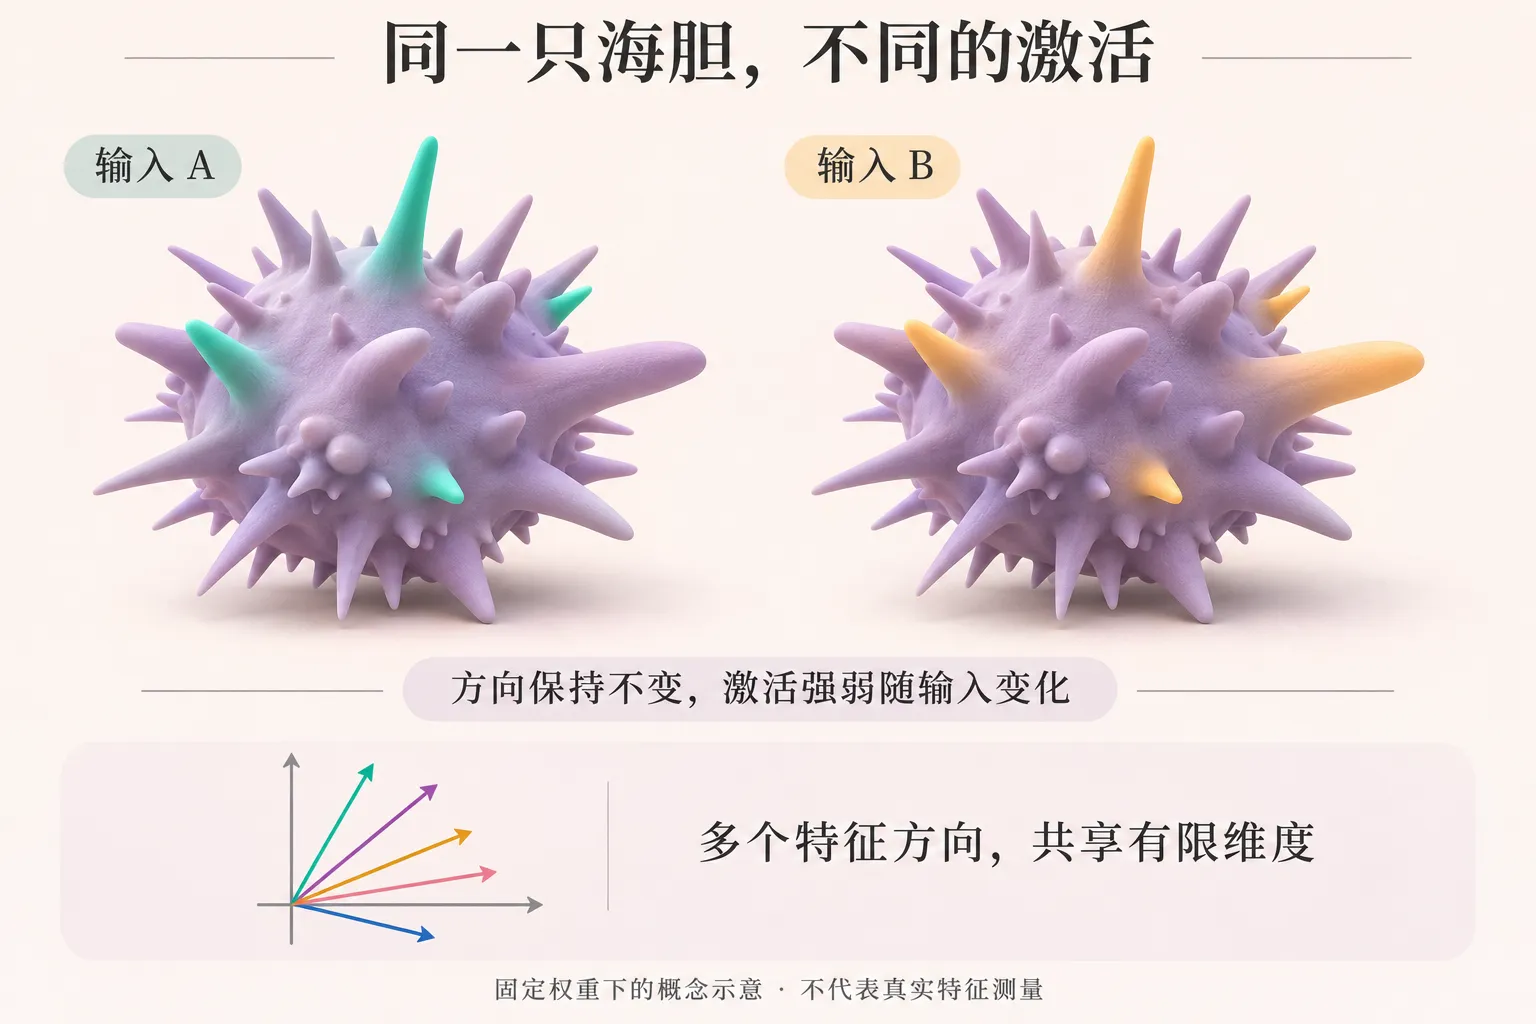
AI 生成的概念插图。在同一层、同一 token 位置,固定权重和选定的特征方向,比较不同输入引起的激活变化。海胆的着色表示激活差异;底部二维图单独示意多个非正交特征方向共享维度,不是真实模型数据。
SAE,是试着把混合的表示拆开
到这里,我才有点理解 Sparse Autoencoder,也就是稀疏自编码器,想解决什么问题。
研究者另外训练一个模型,尝试把原模型内部的激活,分解成少量活跃的特征,再用这些特征重建原来的激活。如果分解得好,就有机会找到比单个神经元更容易解释的模式。相关研究见 Towards Monosemanticity。
这让我觉得,我们开始有办法研究海胆的突起了。
但还不能说,已经找到了模型内部完整的知识地图。提取出的特征是否准确、解释是否可靠,以及它们怎样共同影响输出,都还需要验证。
“知道模型里的计算公式”和“知道这些计算为什么形成某种能力”,中间原来还有这么多事情。
今天先到这里
学到最后,我在记录里说:
i’m pretty exhausted by now.
确实累了。一天里不断在词语、图像和计算之间来回切换,刚觉得一个地方通了,又发现另一个地方接不上。
不过,今天总算把一些以前悬着的东西连起来了:权重矩阵怎么算出神经元的激活,特征为什么不等于单个神经元,以及为什么还需要研究这些内部表示。
我仍然没法熟练地讲清楚 superposition,更谈不上理解 SAE 的具体训练方法。但至少下次再听到“几千亿参数”“某个神经元”“模型学到了某个特征”,我会知道,这几句话说的是不同的东西。
今天这一整天,最后落在了一个很基础的问题上:一个神经元,到底是什么?
原来这个问题,值得退回去重新问一次。