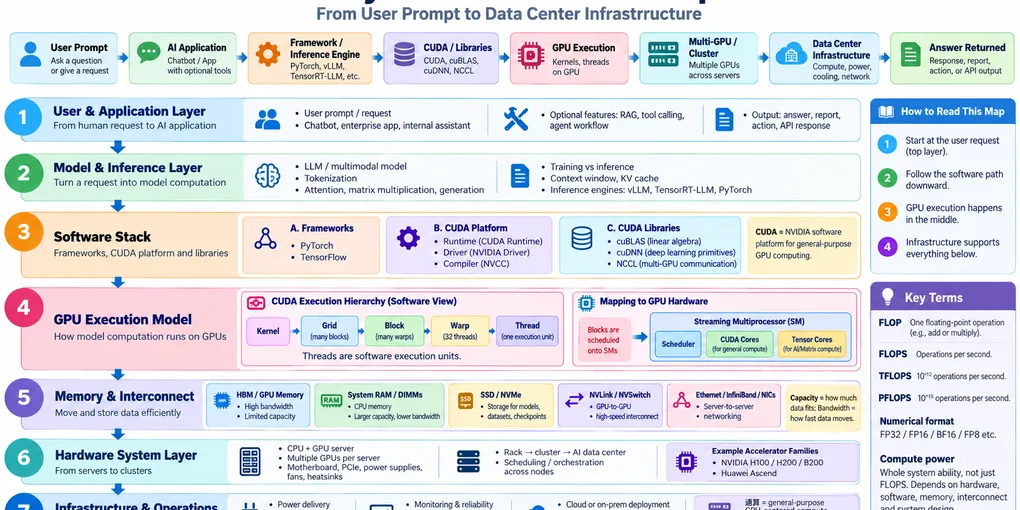
我只想看懂一个聊天框,结果挖出了一座机房
2016 年 AlphaGo 赢了李世石,我是在新闻里看到的。机器能赢顶尖棋手,这件事够震撼。但看完以后,我能拿它干什么?好像也没什么。第二天照常上班。
十年后,情况完全反过来了。豆包、ChatGPT、Kimi,WorkBuddy、Codex、Cursor,还有生图的、生视频的,名字多得我已经记不全。每天打开新闻,总有一家又发了模型,另一家又在某个测试里超过了谁。[2]
以前的软件里当然也有 AI,推荐、搜索、语音识别早就在用。只是那时候它离我很远,现在它就在手边。学英语会用,读书遇到想不通的地方会找它聊,整理资料、写博客也会用,后来还和它一起折腾出一套个人信息整理流程。以前得自己慢慢查、慢慢试的事,现在可以直接把问题抛过去,一边讨论一边做。
用着用着,我开始好奇:这东西到底是怎么做到的?
一开始只是想弄明白一点
我没打算从数学开始,先补完一大套课程,再回来看它能干什么。照那个顺序,大概还没学到自己关心的地方,就已经学不动了。
我的办法比较土。遇到一个东西,先弄清楚它为什么存在、解决什么问题;这一层懂了,再往里走一点。
结果往里走没多久,就开始不对劲。
一个词解释完,又冒出来好几个。模型为什么需要 GPU?GPU 和 CPU 差在哪?显存是什么?CUDA 又在哪一层?每个解释单看都能懂一点,放在一起,我还是不知道整个东西是怎么转起来的。
工作里我听过不少次「几十 P 智算」。以前听到,大概知道是在说算力,也就到这儿了。后来才发现,这个数字后面还得追问:按什么精度算的?理论峰值还是实际表现?最后要跑什么任务?一个天天挂在嘴边的数字,背后藏着这么多没说出口的条件。
看 GPU 服务器的拆机视频,也是类似感觉。机箱一打开,GPU、CPU、内存、硬盘、交换部件,一堆风扇和电源。镜头再往外拉,是服务器之间的网络,是机房的供电和冷却。
问题于是又换了个样子:芯片再厉害,数据送不过去、显存装不下、电和散热跟不上,纸面上的算力到底能用出来多少?
我本来只想弄明白手里这个聊天框,结果越往下挖,东西越多。
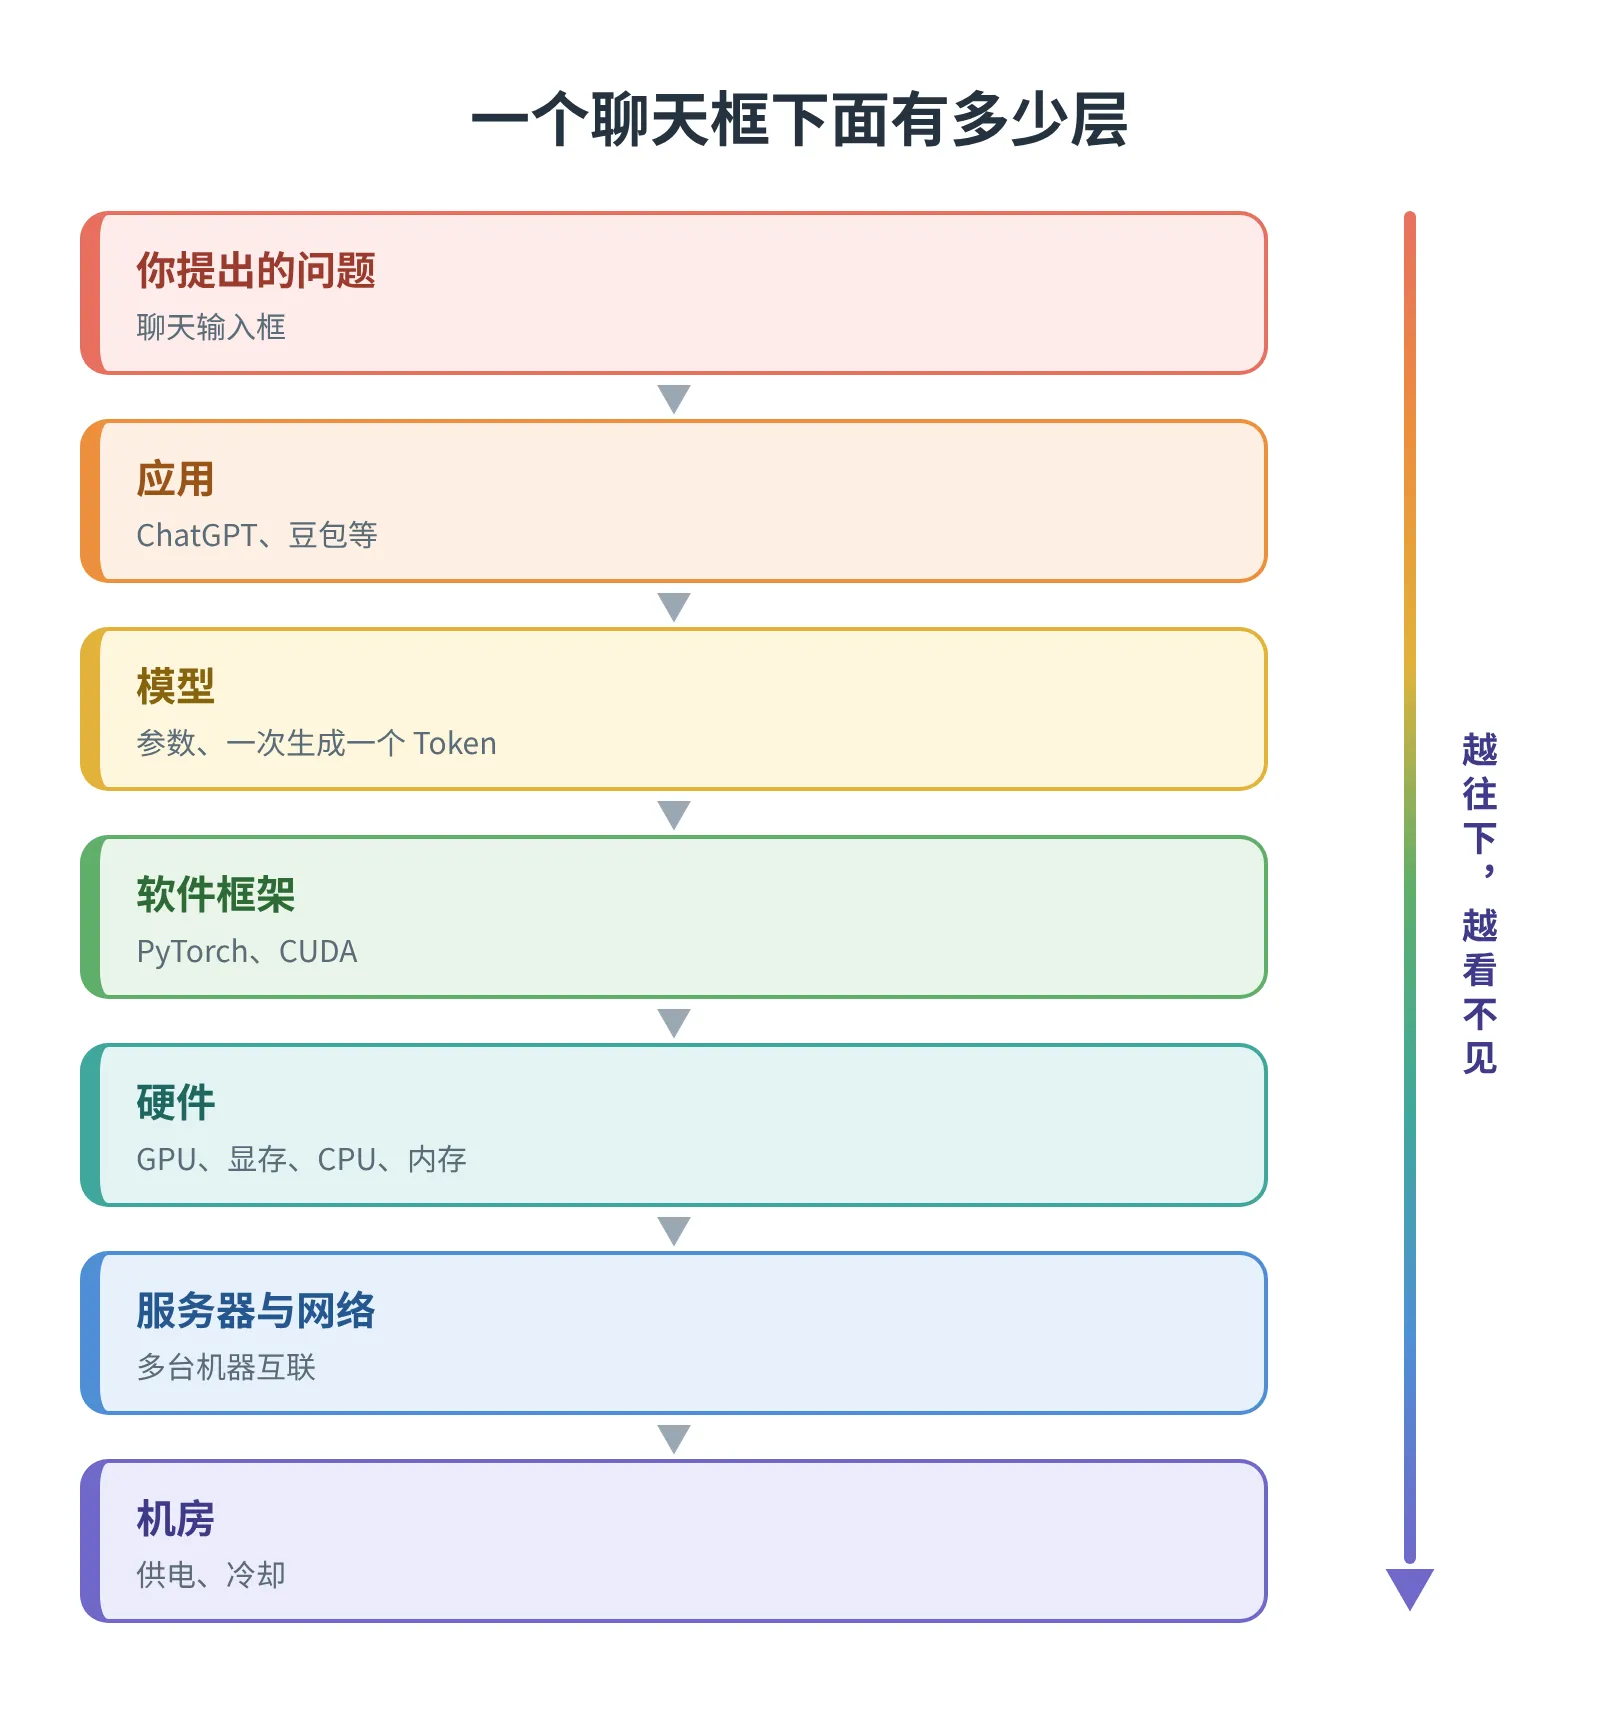 分层图:屏幕上的聊天框,下面连着软件、显卡、机柜和机房
直到画出了两张图
后来,我和 ChatGPT 一起整理了两张整体图。
一张是知识地图,铺开看 AI 都涉及什么:模型、数据、应用、基础设施,还有成本、评估、安全。另一张是系统架构图,从用户敲下一个问题开始,往下是应用、模型、软件,再往下是 GPU、内存、网络和机房设施。
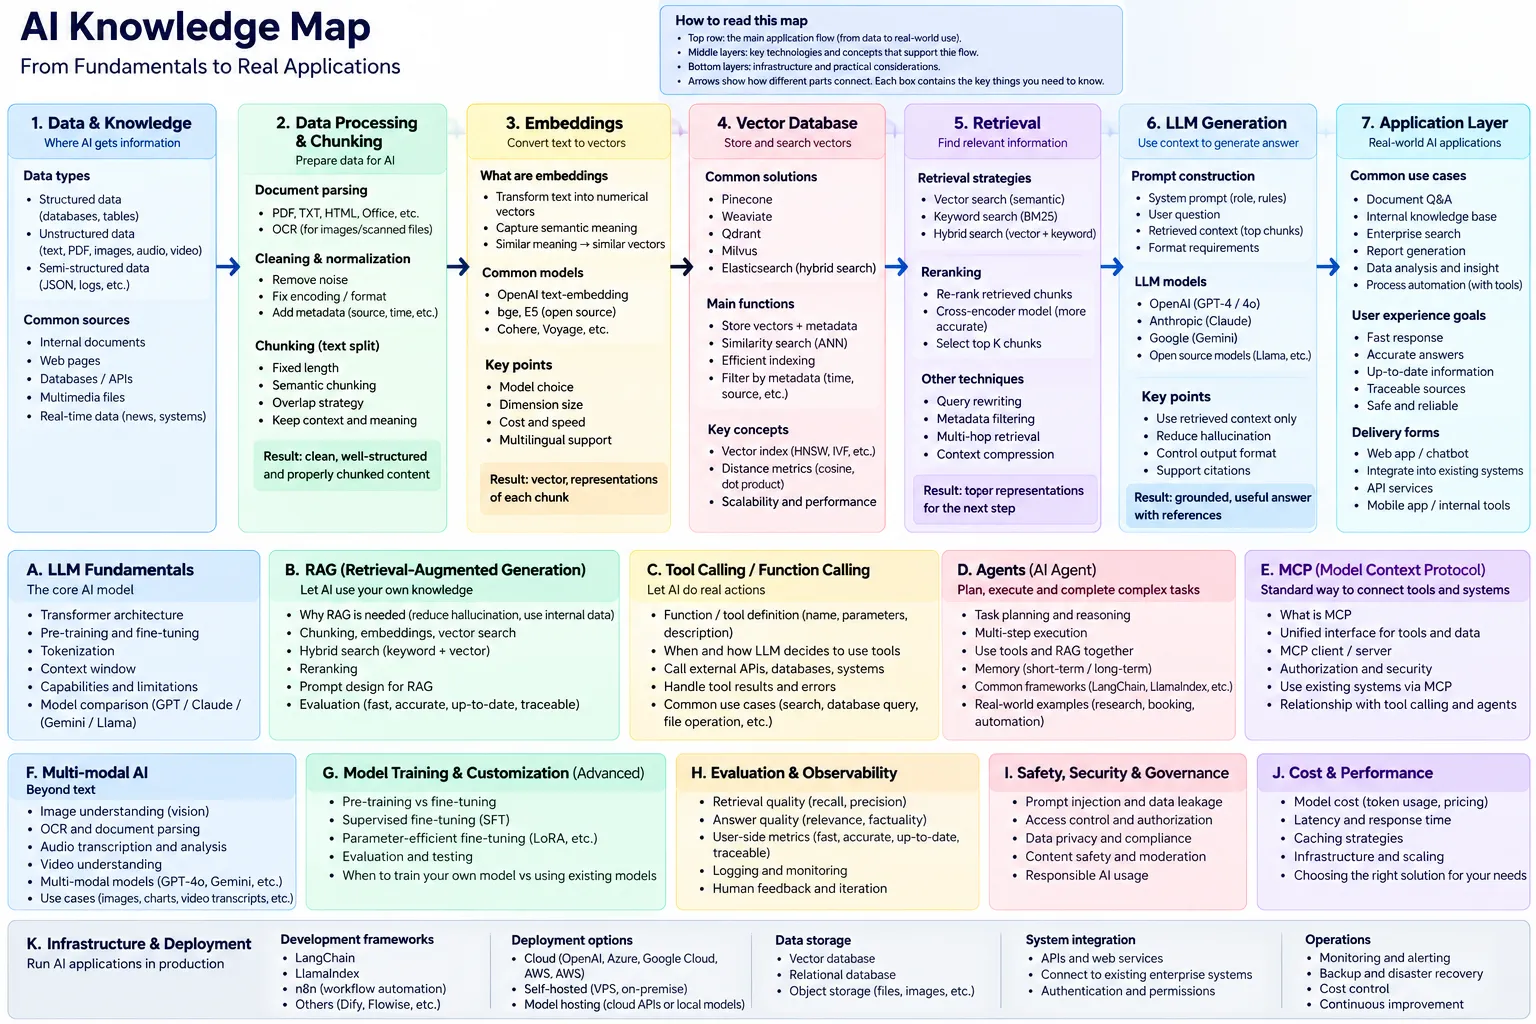 知识地图:AI 都涉及哪些东西
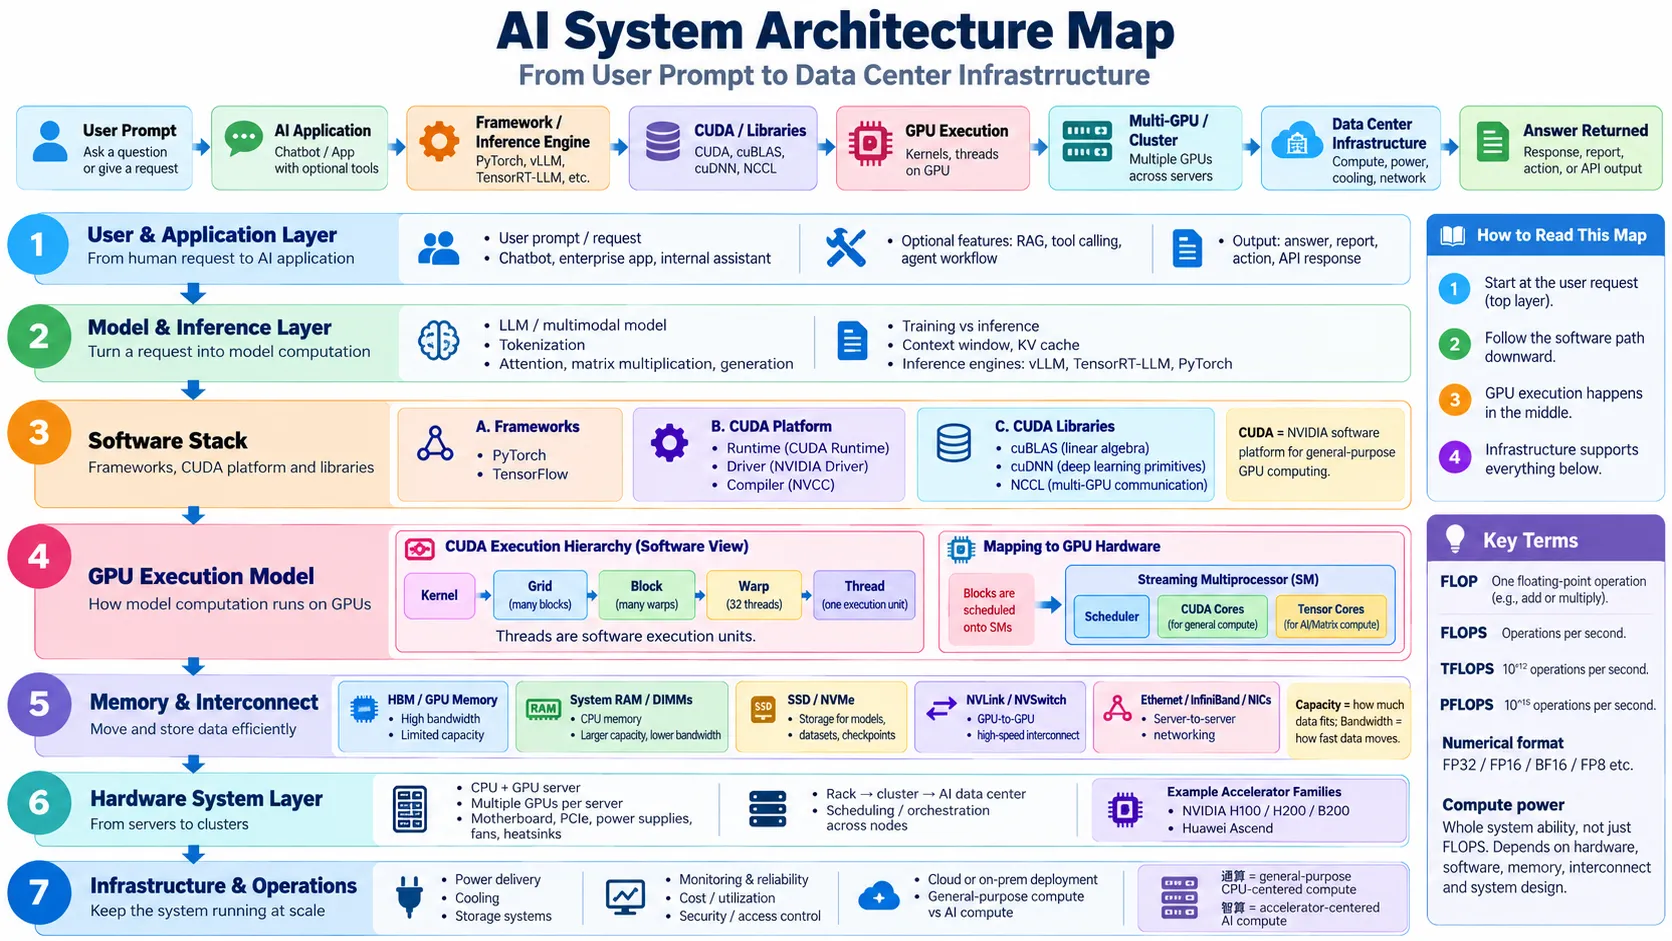 系统架构图:从一个问题一路往下到机房
两张图摆出来,我才第一次有了「原来这么大」的感觉。
平时说 AI,到底在说多大的一个东西?以前看新闻,注意力很容易停在某个模型、某张显卡上。图一展开,才发现它们只是其中一块。屏幕上那个简简单单的输入框,下面连着这么多层。
对我最有用的是,终于知道一个词该放在哪了。
我在笔记里给两张图各写了一个问题。知识地图问的是「What do I need to know?」,架构图问的是「Where does this concept live, and how does it connect to the rest of the system?」
以前学 CUDA,我觉得它特别难。回头想想,一部分难其实来自没有全局。连它在哪、上下接着什么都不知道,当然越听越乱。
有了图,再碰到新概念,我可以先把它放进去。不一定马上懂,但至少知道它和前面学过的东西是什么关系。今天上午学模型推理,我已经能把模型的计算、显存的压力、软件怎么调度这些资源串到一起了。
这些东西以前是散的,现在才慢慢接上。
然后又想到人脑
学到语言模型,有一点让我印象挺深:背后是一大堆训练出来的参数,模型靠这些参数和上下文,一次产生一个 Token,再接着产生下一个。
这个过程我开始能理解了。可理解了以后,反而有点不满足。
为什么这样做,就能回答问题、解释概念,甚至解决一些没直接见过的问题?它记住的东西在哪?它所谓的推理,又发生在什么地方?
昨晚和 ChatGPT 聊着聊着,我突然想到人脑。人脑里也是大量神经元,很多神经元一起形成某种活动模式;模型里用向量表示信息。两者能不能联系起来?
当然,神经元不只是亮或不亮,一个活动模式也不能直接等同于长期记忆。但这个念头让我觉得,也许有些联系值得往下想。
后来我把它收成了一句话:
人脑和 AI 或许都能让许多单元共同表示一个事物,通过学习留下经验,再把学到的关系用到新问题上。
我关心的不是人脑是不是一台电脑,而是两种完全不同的东西,有没有可能学会某些相似的办法:怎么表示一个事物,怎么留下经验,怎么把过去学到的用到今天。
查了一圈,发现这方面真有人在做。有模型用神经元实现向量表示,模拟工作记忆和部分推理任务;也有研究试着解释,具体经历怎样和关系结构结合,让一个系统能推断没直接经历过的情况。[3][4]
这当然证明不了人脑和大模型是一回事。但至少说明,这个联系不是我随口瞎想、完全没人碰过的。
想到这儿,我对 AI 的兴趣又挪了一点。最初只是想看懂工具怎么用,现在也想知道:它为什么会有这些能力?而我们自己的这些能力,又是怎么来的?
LLM 会一直这样下去吗
今天上午学完,我在笔记里又记了一个想法。
我自己说话,经常是先有个意思,或者脑子里先有个画面,然后才去找词。有时候中文里已经想明白了,英语却说不出来。这时候很明显:意思已经在那儿了,词还没跟上。
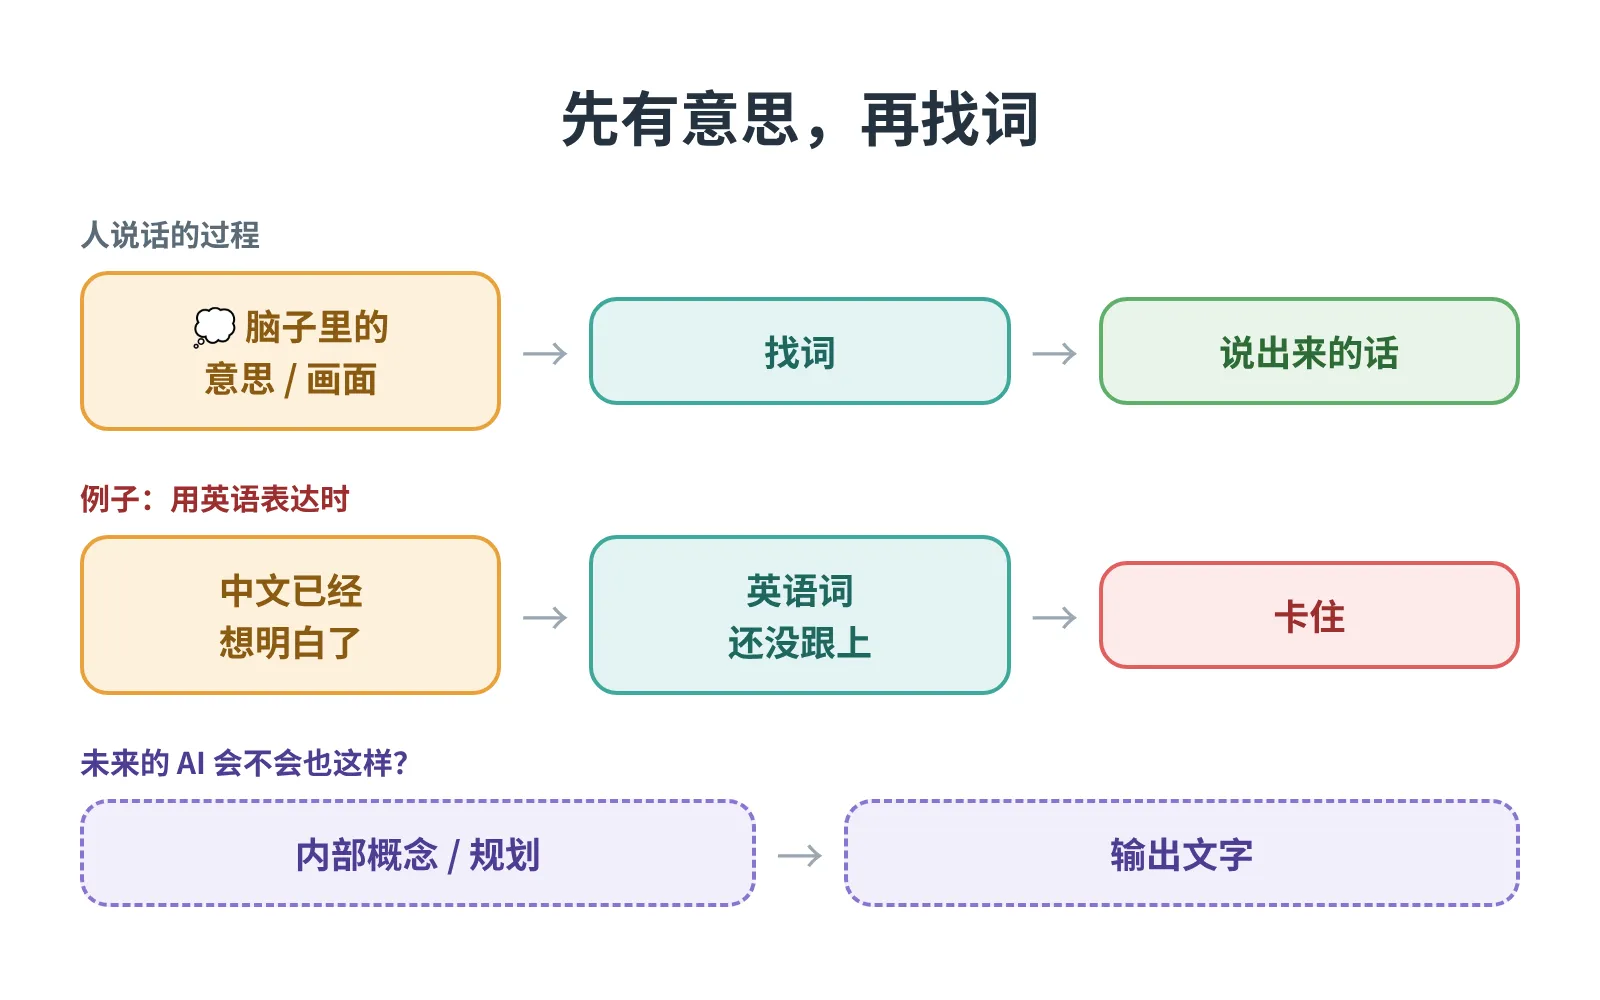 先有意思,再找词
那未来的 AI,会不会也先在内部形成某种概念,在里面想问题、做规划,等到要和人交流时,再把结果说出来?
我知道这只是自己的感受,不能拿来直接解释人脑。现在的语言模型内部,也远比「接着猜下一个词」复杂;逐个产生 Token,不等于每一步只盯着眼前一个词。
但我还是想问:智能一定要和这种生成方式绑得这么紧吗?
Transformer 是今天很多模型的地基。Attention 让不同位置的信息能互相联系,这套架构也特别适合吃下大规模算力来训练。[1] 下一次大的变化,是继续把它做大,还是冒出另一种办法?也可能它还在,只是退到一个更大的系统里,负责其中一部分。
这些问题我现在答不了。说实话,我还没学到能判断自己哪些猜想站得住的程度。
不过先把问题留下来也挺好。以后回头看看,当时是想对了一点,还是想偏了。
先继续学,也先写下来
最近的学习方式慢慢固定下来了:找英文视频或文章,看一段,手写点笔记,再试着用自己的话讲一遍,和 ChatGPT 讨论。抽象的东西我还是更需要动画和图,光听人讲,讲很久也不一定能在脑子里搭起来。
Attention 那部分花了我不少力气。学到后来,感觉再往数学细节里钻,当天已经吃不下了,就留着基本理解先停在那儿。现在回头看,也没什么问题,后面的内容照样能接着学。
我想先把整体的空白补一些,再往自己感兴趣的地方钻。英语继续拿来学和讨论,博客先用中文写。这样比较实际,不用每一步都同时对付内容和表达两件事。
写这篇也是这个过程的一部分。前面看了不少、聊了不少,总得自己讲一遍。能讲到哪、哪里还讲不清,一写就露出来了。
十年前在新闻里看 AlphaGo,我大概想不到,有一天自己会坐在电脑前,和 AI 讨论它到底怎么工作,顺手又扯到人脑和智能。
现在这事已经在发生了。
后面会走到哪,我也不知道。先把这两张图放在这儿,以后学到什么,再一点点往里填。
资料与出处:
- 个人笔记:AI Learning Notes,2026-10-10 版本。
- [1] Vaswani 等,2017,Attention Is All You Need。
- [2] OpenAI,2022,Introducing ChatGPT。供十年变化的背景核对参考。
- [3] Eliasmith 等,2012,Science,A Large-Scale Model of the Functioning Brain。
- [4] Whittington 等,2020,Cell,The Tolman-Eichenbaum Machine。