从 Backpropagation 想起的,LLM 竟然是这个?
这两天继续学 AI,终于集中学到了 Transformer,然后又一路追到 gradient descent、backpropagation。一堆专业词语,刚记住一个,后面又来几个。
我也不是数学专业的人,主要靠 3Blue1Brown 这种把抽象东西画成动画的视频,先掌握个大概。真要把里面的公式逐个推一遍,估计学到这儿就得停很久了。
其实我对 Transformer 本身没什么感觉。看着就是一堆矩阵运算,乘过去,变一下,再乘回来。而这些线性代数的东西,早都扔回大学里头了。
说实话,从来没想过线性代数这么有用。以前学的时候,能把题做出来就行,至于这些矩阵到底能拿来干什么,好像也没怎么认真想过。过了二十多年,又在这里碰上了。
不过数学细节没吃下来,不妨碍基本过程逐渐清晰。真正让我有点兴奋的,是学到后面,脑海里突然开始出现一个东西。
以前我想不通 AI 怎么能处理“含义”,现在似乎能想象一点了。
电脑怎么就能懂意思了?
以前我对电脑的认识,大概就是存东西、执行程序。
人把规则规划好,把程序写好,CPU 按照指令去执行。互联网再把各种内容连起来,搜得到,存得下,传得快。这些我都能理解。
这里当然也有复杂计算,也有很厉害的软件。但在我的直觉里,电脑做什么,总得有人先告诉它怎么做。信息记在哪里,程序怎么执行,都还算能想象。
“含义”就不一样了。
一个词在不同地方能有不同意思,两句话用词完全不同,却可能在说同一件事。有些话甚至没有明说,人还是能听出来。这些抽象的东西,怎么放进电脑里?又怎么变成它能算的东西?
我每天都在用 AI,也知道它能解释、分析,还能顺着我的想法讨论。但“它能做到”和“我能想象它怎么做到”,中间一直隔着一块。
前一篇文章里,我从聊天框一路挖到了机房,知道下面有 GPU、显存、CUDA,有模型和一大堆参数。机器怎么撑起来,开始有了轮廓。但那些参数,为什么能让它表现得像是懂了我的意思?这个问题还在。
这两天才往里面又走了一点。
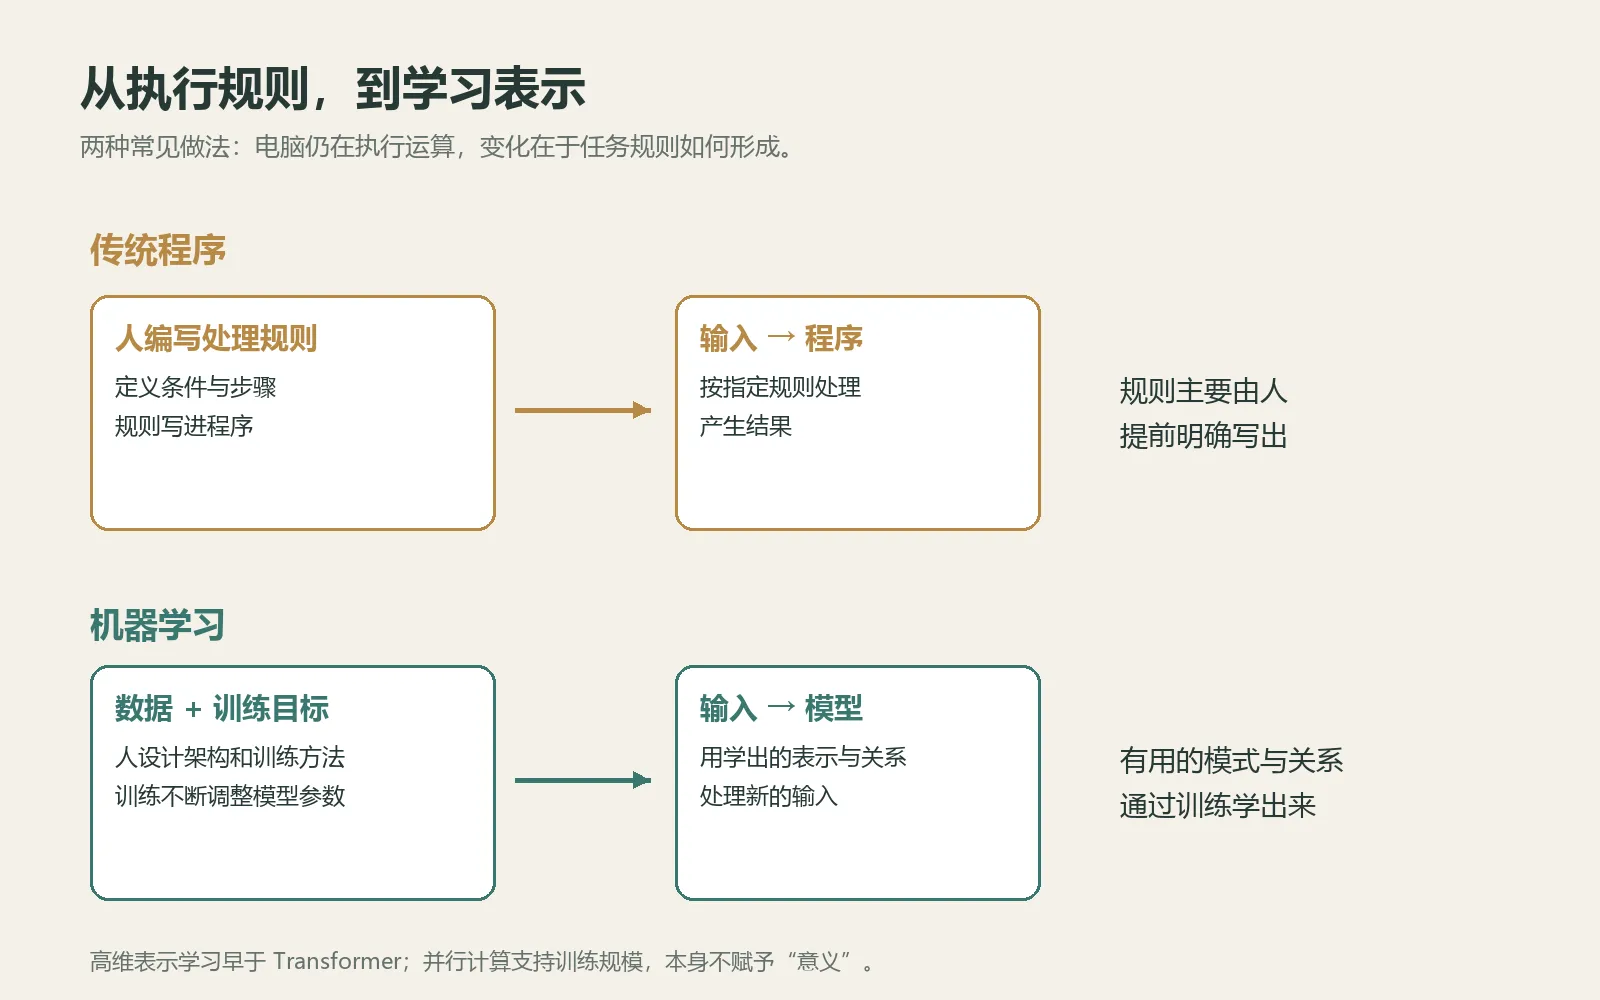
以前我熟悉的是上面那种做法。现在开始能想象,下面这种学习是怎么发生的。
一堆矩阵,慢慢接上了
Transformer 的基本过程,现在对我来说比较清楚了:文字先变成 token,再变成向量,进入模型以后,通过 attention 和其他变换,一层层改变自己的表示,最后产生下一个 token 的概率。
我很自然地把它和名字里的 transform 联系起来:源数据进去,经过一堆运算,变了。
当然,变化的不是屏幕上那些字,而是它们在模型内部的数值表示。Attention 让一个位置的表示结合上下文,其他网络部分再用训练出来的参数继续加工。同一个词放在不同句子里,经过这些处理,内部表示就可以不一样。
以前我觉得电脑面对的是字,现在开始能想象,它内部处理的是一组组数值,以及这些数值之间的关系。我们说的“含义”,可以在这样的关系里得到某种表示。
这里也要修正一下我最初的想法。我一开始以为,是 Transformer 加上 parallel computation,让电脑突然有了这种能力。后来讨论才知道,从数据中学习表示,在 Transformer 之前就已经有了。Transformer 提供了很有效的架构,并行计算又让大规模训练更可行。[1][2]
并行计算负责让它算得动,至于学出什么,还得看数据、训练目标,以及参数怎么调整。
于是问题又往前追了一步:这些 parameter 到底怎么来的?
学来的。
这句话以前也听过,但总觉得太笼统。什么叫学来了?难道把一堆资料塞进去,参数就自己出现了?
再往前追,就到了训练
这次学到 loss 和 gradient descent,才开始觉得,“学习”这件事至少能用一个过程解释了。
模型先用当前的参数做预测,算出预测和训练目标之间的差距,这个差距用 loss 来衡量。然后调整参数,再预测,再调整。很多次以后,参数逐渐变成另一种组合。
它没有人一样“我要认识世界”的念头。但为了把预测做好,模型会学到数据里的许多规律和关系。这些东西留在参数里,新的输入进来时,它就可以继续用。[2]
再追问,往哪个方向调?调多少?又是一堆术语。
最绕的就是 backpropagation,反向传播。看着误差从后面一层层往前算,链式法则再一路接过去,我的数学记忆已经不太够用了。
不过,优化这个大方向还是能理解的。类似二次函数找最低点,最低点的斜率是零,这个我还记得。只不过模型面对的不是一条简单曲线,而是大量参数共同决定的 loss,要在一个多维的空间里不断找下降的方向。
Gradient descent 说的是沿着什么方向调整参数,backpropagation 帮忙算出每个参数对应的梯度。前者用梯度更新,后者负责把梯度算出来。真实训练当然比二次函数复杂得多,也不保证找到一个完美的最低点,但到这里,我已经能抓住它们分别在干什么了。
剩下的数学,暂时先放着。现在就全部深究,后面的东西又没空看了。
也就是学到这儿,前面的向量、pattern、参数和训练,突然开始在脑海里接上。
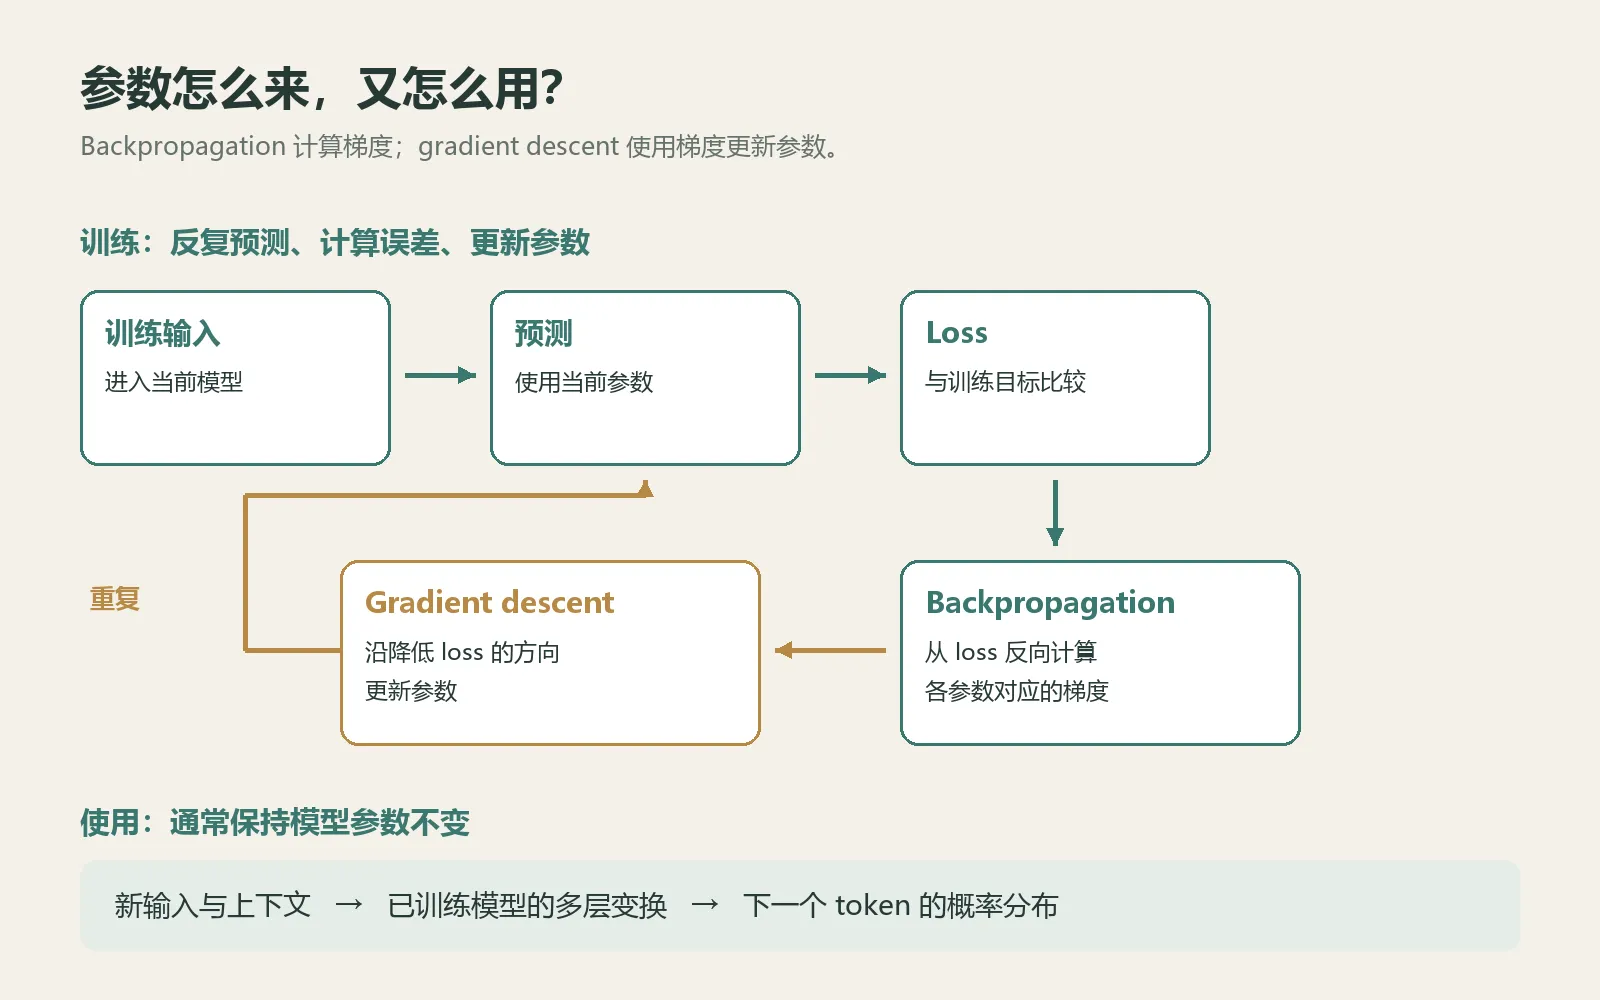
先把这些词各自负责什么接起来,数学细节以后再补。
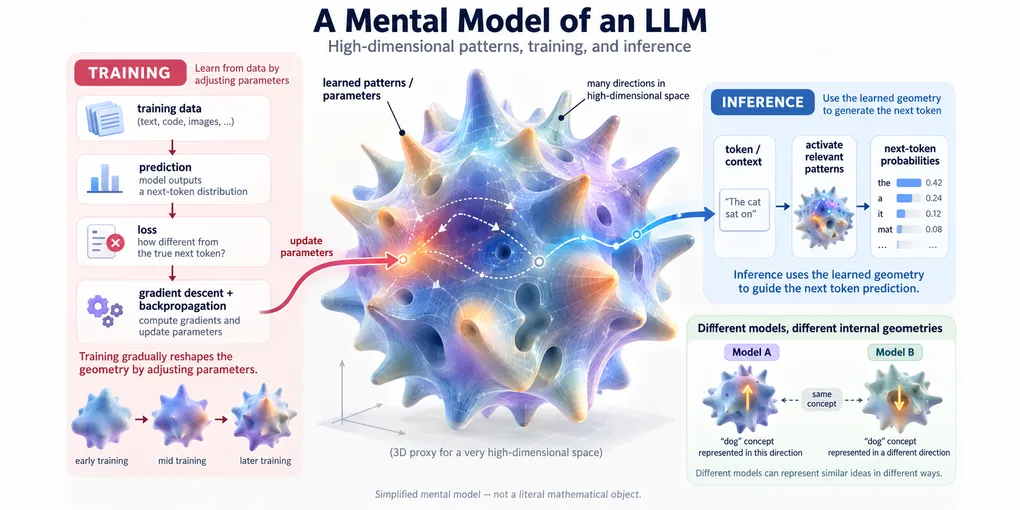
然后,脑海里出现了一个球
准确说,是一个多维的不规则物体。
但人类没办法把远远超过三维的空间直接想象出来,我也没这个本事,只能先拿三维的圆球代替。
这个球表面有很多突起,有点像水雷。但每个突起都不一样,有的长,有的短,有的斜着,有的很尖,有的比较钝。方向、角度、形状,都不一样。画成凹陷也行,向里还是向外不重要。
在我的想象里,这些不同的结构,共同表示模型学出来的 pattern。
它看着有点像一只海胆,我干脆管它叫「参数海胆(Parameter Sea Urchin)」。
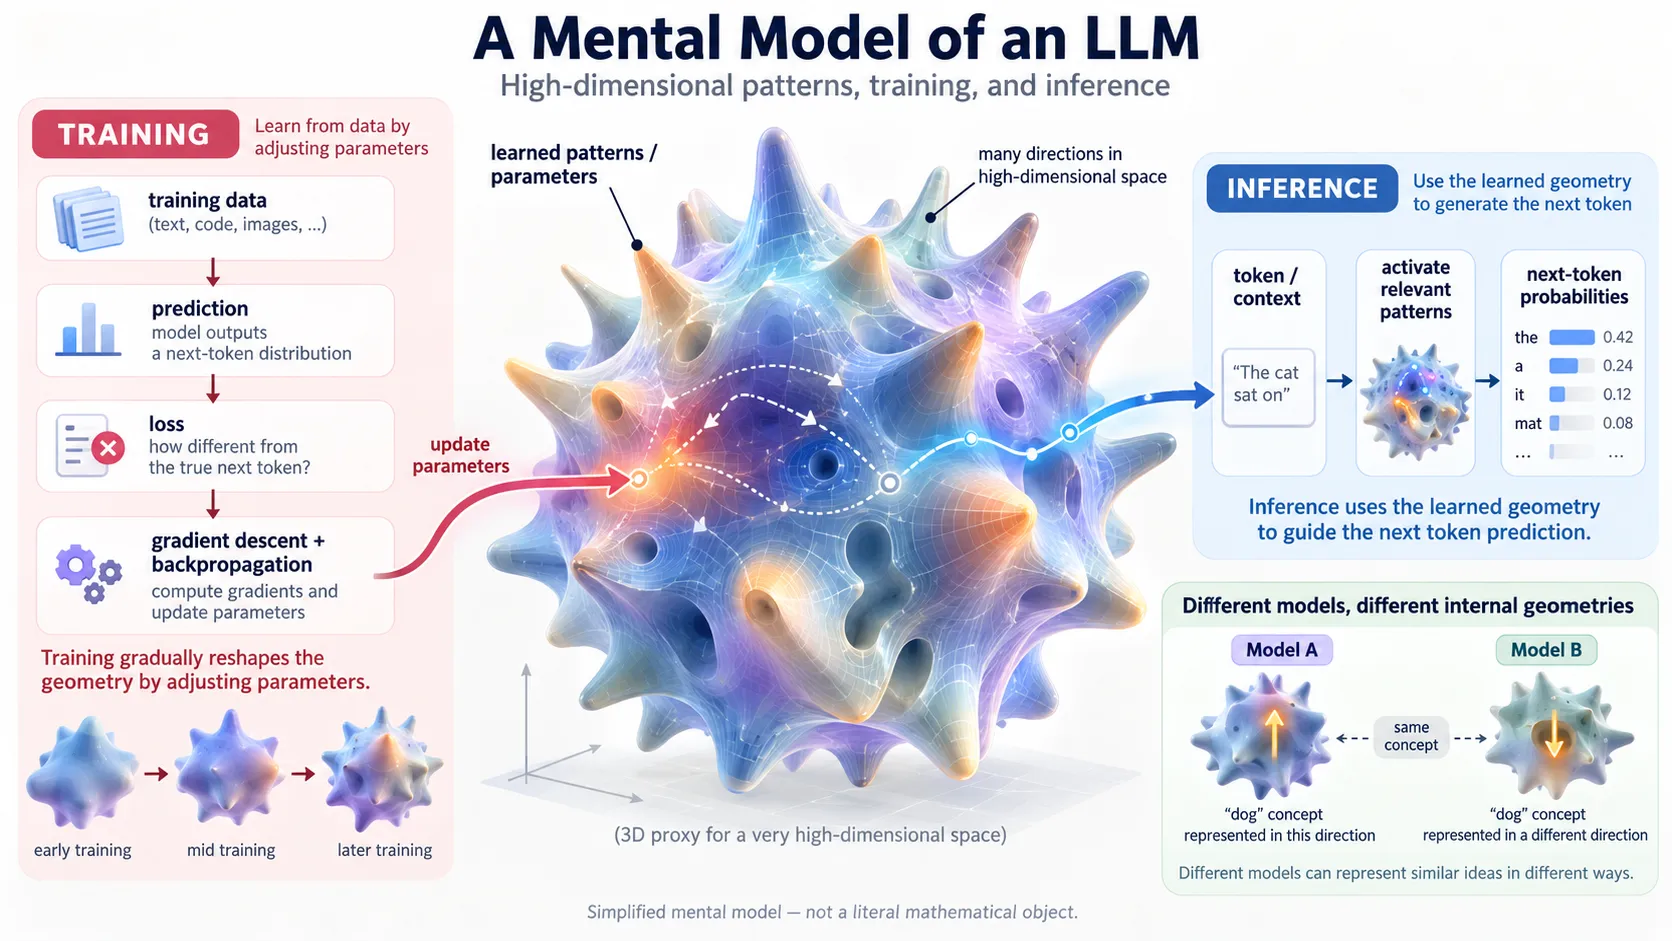
用一个三维的球,暂时代替无法画出来的高维结构。这是我的想象,不是模型的真实外形。
训练,就是不断调整它们。模型做一次预测,产生 loss,再通过梯度和参数更新,改一点。训练很多次以后,整个物体慢慢形成自己的样子。
等到使用的时候,输入进来,经过这个已经训练出来的模型,被一层层变换,再产生输出。
我知道,这个比喻把几件事揉在一起了:参数怎样组合,输入怎样被表示,模型学出了哪些关系,并不是同一个空间。模型运行时,也不会真的绕着球面去找哪个突起最合适。这些突起更不能简单理解成,一个代表篮球,另一个代表苹果。
但先借这个形象,我开始能把整个过程放在脑海里了。训练改变参数,参数影响输入的处理,输入又结合上下文,最后变成输出。那些原本一个个分开的词,现在可以一起想。
顺着这个球,我还想到另一件事:每个模型长出来的样子,应该都不一样。
很粗糙地说,Qwen 里面“向上”可能表示大,另一个模型里面“向下”可能表示大。它们最后都能表达“大”这个概念,但内部怎么表示,不需要完全相同。这只是为了帮助想象随手举的例子,不是说我知道它们真的用什么方向。
原来,也不用由人提前替所有模型规定好,“大”放在哪,“小”放在哪,“责任”和“悲伤”又分别占哪个位置。人设计架构和训练方法,模型通过训练,自己学出对任务有用的内部关系。[2]
这个地方,让我觉得挺有意思。
先把这个样子留下来
回头想想,这次最重要的变化,是我终于能开始想象,数值运算怎么和“意义”联系起来。
以前总觉得,一边是电脑、程序和指令,另一边是人能理解的概念和含义。中间怎么接上,我不知道。现在知道,可以把信息变成高维表示,通过训练学出关系,再用这些关系处理新的输入。
这当然还解释不了所有问题。模型对意义的表示和运用,到底和人的理解差多远?它能推理到什么程度?那些关系究竟怎么分布在参数里?我现在都讲不清。
但至少,它不再只是一个完全无法想象的黑箱。
这只带着很多突起的参数海胆,可能以后学深了,会被我改得面目全非。也可能有一天回头看,觉得当时把好几件事混在一起,画得实在很粗糙。
先留下来吧。毕竟学了这两天,脑海里终于冒出了一个样子。趁现在还能说清楚,记一下,以后再回来看看。
资料与出处:
- 个人学习记录:AI Learning Notes,2026-10-10 至 2026-10-11。
- 学习视频:3Blue1Brown 的神经网络系列。
- [1] Vaswani 等,2017,Attention Is All You Need。
- [2] Goodfellow、Bengio、Courville,Deep Learning:Introduction 与 Representation Learning。