学到 Attention,我自己的 attention 不够了
我自己在学习 Attention,但是自己的 attention 不够了。
以前我在笔记里给这一节取过一个标题,叫 Attention Mechanism — Enough for Now。当时我记住了一个大概:Attention 能让一个 token 的表示带上上下文。后来写神经元那篇,我为了看清 MLP 怎么算,还特意说了一句,先跳过 Attention。
这次回来补它。我还是用上一篇的 GPT-3 175B,把问题缩小到一句话里的一个位置。假设 the black cat 对应三个 token,我只跟着最后的 cat 走一遍。它带着 12,288 个数进来,出来的时候还是 12,288 个数。中间发生了什么? GPT-3 论文第 2.1 节
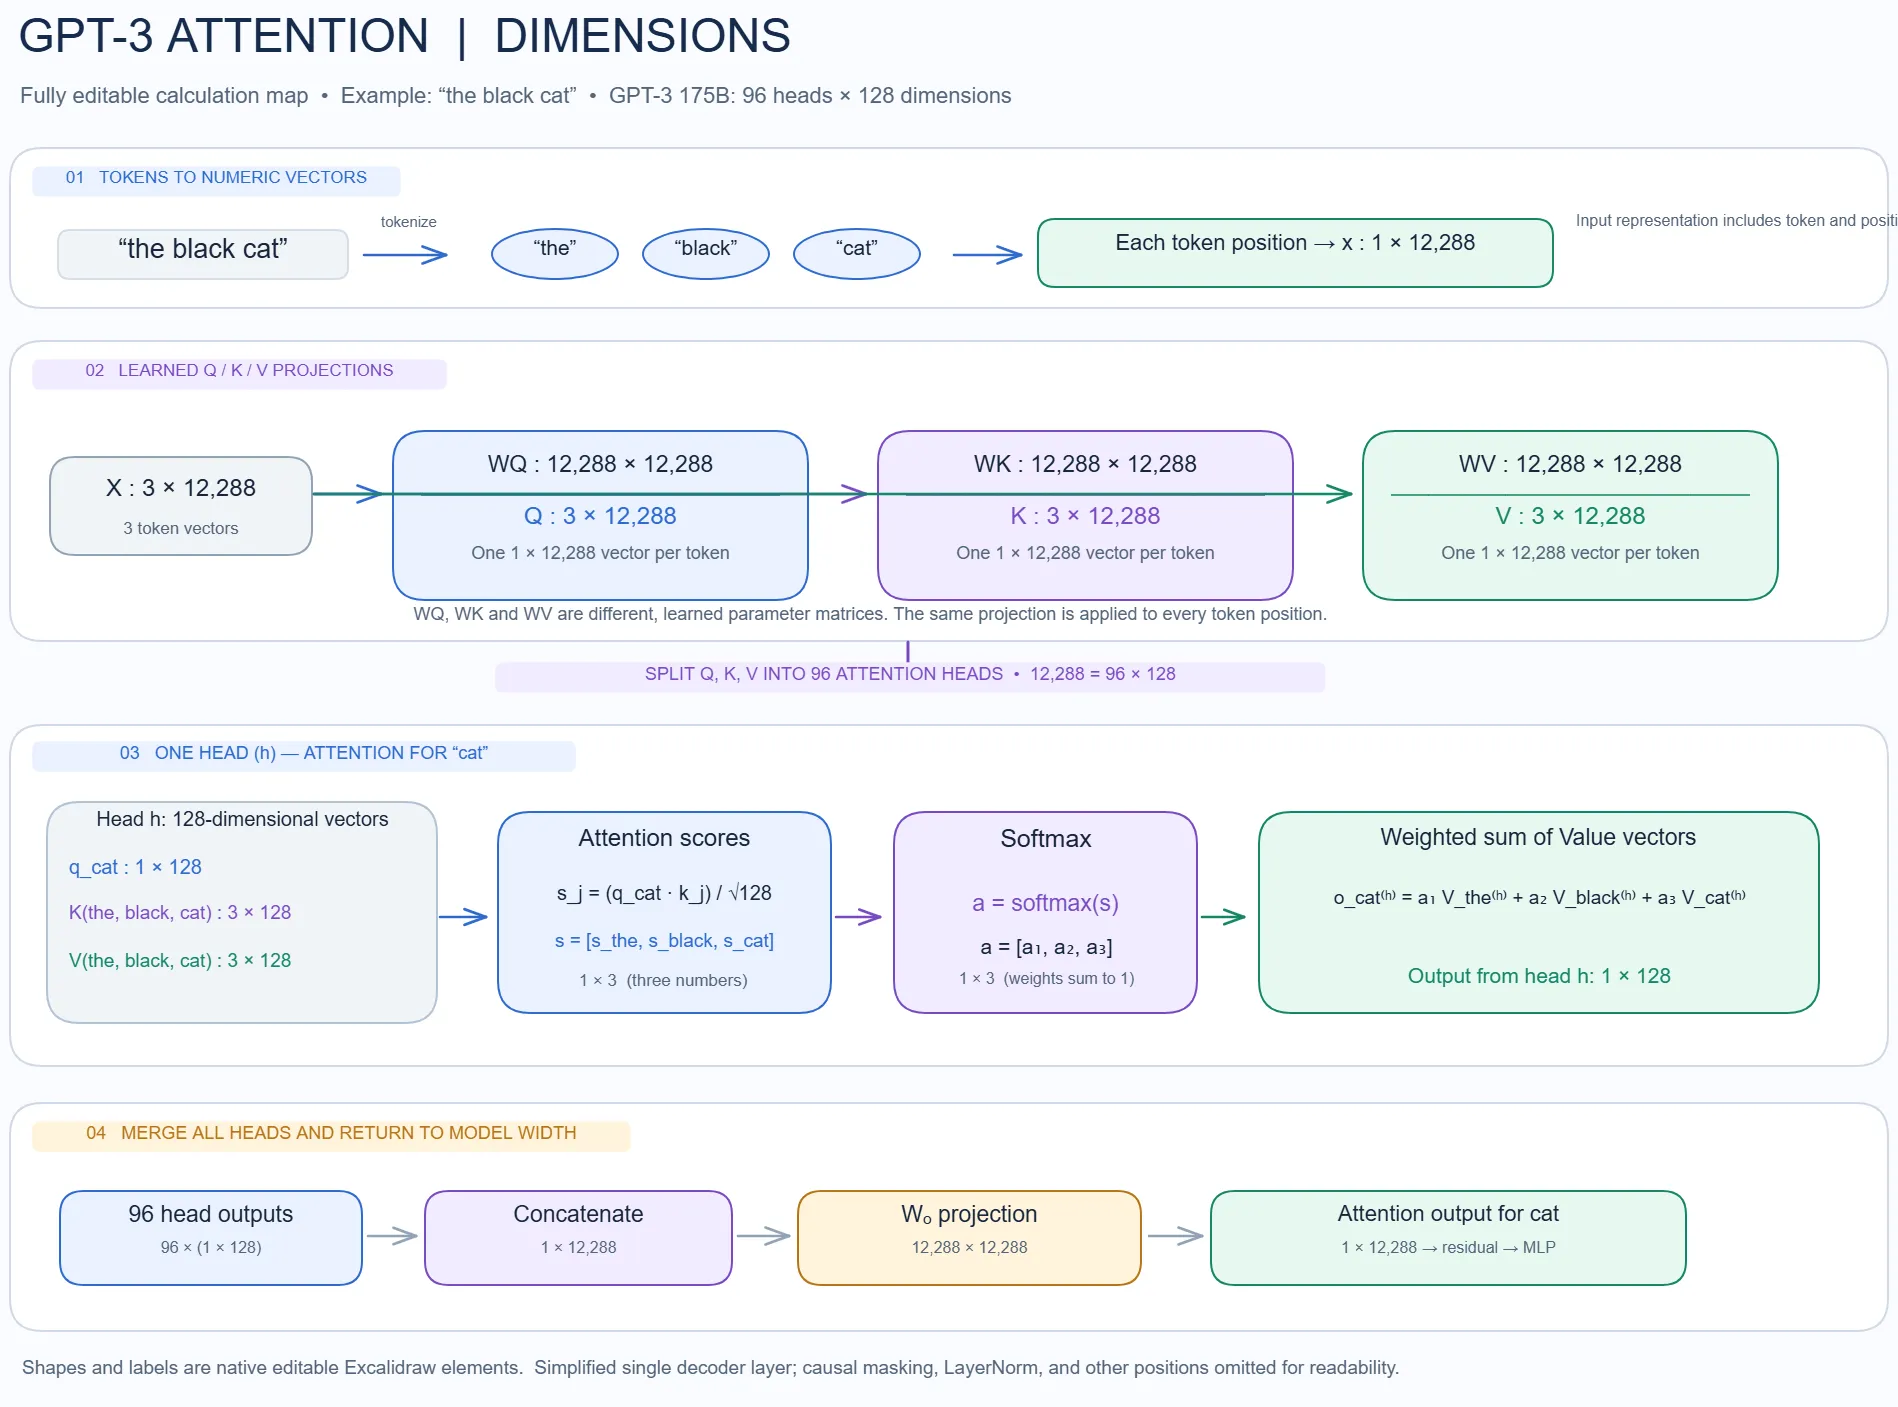
计算总览。第 02 步的箭头应读作从同一个输入 X 分别计算 Q、K、V。
我怎么理解 Q、K、V
我最早在笔记里给 Q 和 K 各写了一句。Q 是「我在找什么?」,K 是「你这里有什么?」。V 当时先跳过了。现在回头看,「你这里有什么」这句容易把 K 和 V 混在一起。我会把它拆成两个问题:
- Q(Query) 是我用来问的。轮到更新
cat时,就拿cat的 Q 去跟各个位置比。 - K(Key) 是对方拿来跟我匹配的。比如
black的 K 和cat的 Q 得分越高,black在这次计算里就占得越多。 - V(Value) 是对方实际贡献的那串数。
black占多少,是前面算出的权重。这个权重乘的是black的 V。
同一个位置有这三样东西,因为同一条输入向量会分别乘上三套学到的权重。比如 cat 的 Q 可以去找别的位置,也会和它自己的 K 打分。算完以后,它自己的 V 也能贡献一份。对我来说,这一步想通以后,图上的三条线就有了分工:Q 和 K 决定各取多少,V 是拿来混合的内容。 Transformer 论文第 3.2 节
三个位置,三个分数,128 个数
先只看 96 个头中的一个。这个头里,每个位置的 Q、K、V 都有 128 个数。我把 cat 的 Q 分别跟 the、black、cat 的 K 做点积,每个结果再除以 √128。三个位置,正好得到三个分数。
经过 softmax,三个分数变成三个加起来等于 1 的权重。然后拿这三个权重,分别乘上三个位置的 V,再加起来。比如 black 的权重如果是 0.6,就把它的 V 里的每个数都乘以 0.6,再跟另外两个位置的贡献相加。
我在原来的草图底部写了这个加权求和。回头检查尺寸时,才看清自己应该在哪里标一个 128。每个 V 都有 128 个数,加起来还是 128 个。三个权重是因为 cat 能看三个位置,128 维是因为我只算了一个头。 Transformer 论文第 3.2 节
Split Heads 到底拆了什么?
真正让我卡住的是图中间那行 12,288 = 96 × 128。这个乘法我会,那个 split 我还是没想透。是把 cat 进来时的 12,288 个数切成 96 段,每个头只看到自己那 128 个数吗?
把图缩到 6 个数、3 个头,每个头 2 维。只拿 Q 来看。如果用一个大矩阵一次算出 6 个结果,头 1 取前两个,头 2 取中间两个,头 3 取最后两个。头 1 的这两个结果都可以用到输入里的全部 6 个数。头 2、头 3 也一样,只是各自用不同的权重。K 和 V 各用自己的矩阵,照这个方式分组。 Transformer 论文第 3.2.2 节
小图只画 Q。把三个头的投影放进一块大矩阵里算,得到的就是可以按头分组的六个数。
再回到 GPT-3。96 个头各自用自己的 Q、K、V 重算刚才那套过程,各给 cat 一条 128 维的结果。把 96 条结果拼起来,回到 12,288 维。拼接只是把它们并排放好,之后的 W_O 才用学到的权重混合这些结果。再把 Attention 的输出加回原来的表示,就能接着看这一层的 MLP。 Transformer 论文第 3.2.2 节
这次停在这里
我在学习记录里写,got stuck by split, but the whole process of attention is generally understood。
我现在能沿着图,从 cat 的 12,288 个数一路走到加回残差。至于分头,投影之后再分组,这句话我能复述了。要我合上图自己重画一遍,大概还会在那条线上停一下。
那就先停在这里。下次从这张图接到 MLP,看看同一个 Transformer 层的两半怎么连起来。